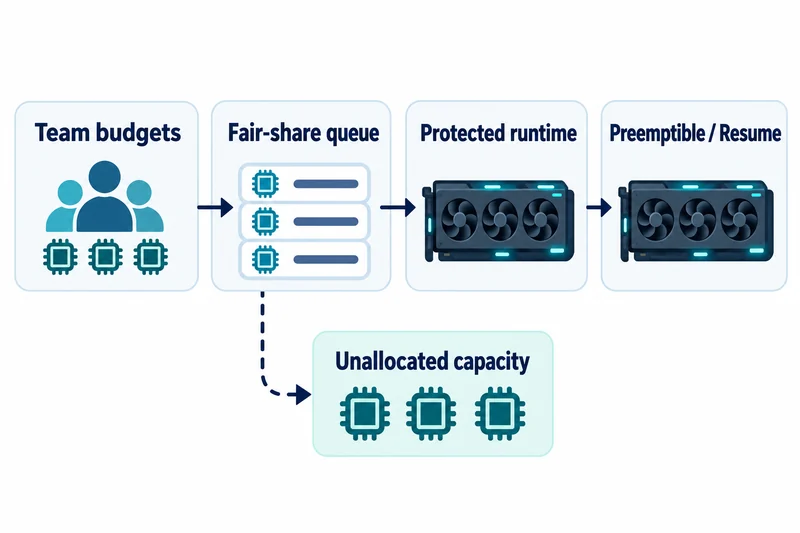
Ai2 在10月9日的报告中公布了更换 GPU 集群调度器的结果。基于优先级的调度器被 GPU 时间预算、分层公平份额(fair-share)和时间分片契约取代。
部署自7月底起逐个集群推进;在报告的30天内,各团队拿到了应得 GPU 时间的98%。应得时间是按小时以实际需求为上限的配额。
集群占用率在变更前后均为98%。这是运营方的观测,不是独立基准测试。
起点是旧方案的瓶颈。在需求达到供给2~3倍的情况下,没有成本的 HIGH 优先级最终覆盖了100%的作业,一些用户还用空作业占住 GPU。
按时间而非机器分配的分层公平份额
Ai2 的做法是给团队分配 GPU 时间份额,而不是直接分配 GPU。管理者按比例把预算分给项目和研究者,调度器在默认7天的滑动回看窗口内跟踪占用。
使用低于配额的组的作业排在使用超额的组之前。时间预算是一段窗口内的使用权,不是持续预留同一批设备。
Ai2 自己也说算法并不新。Slurm 的 Fair Tree 在账号树中比较同一父节点下兄弟项的份额与用量。
Ai2 只是引用了这一脉络,没有证据表明其调度器运行的是 Slurm 的实现。
最短运行时间契约与抢占边界
作业提交时声明取得有意义进展所需的最短运行时间,在此期间免于抢占。Ai2 设定的保护上限是8小时。
保护窗口结束后,可恢复的作业会自动重新排队。最短时间设为0即表示未分配时间,不计入任何预算,从一开始就可被抢占。
借助这一契约,故障主机也能在作业达到最短运行时间时自动清空。Ai2 报告需要人工介入的维修减少了74%。
易失的交互会话则较吃亏:在8小时保护后被抢占,状态只能手动重建。Ai2 还在调查可能拉长最大规模作业等待时间的容量碎片化。
保护时长与重启成本的取舍
设计问题在于把可恢复工作单位定为多大。窗口越短,重新分配的机会越多;但如果每次重启都丢掉进展,这些机会的价值就会下降。
较长的窗口给作业留出推进空间,却会推迟等待同一硬件的其他作业。仅凭占用率似乎无法在两者之间做出选择。
更现实的试点会在队列延迟旁边记录检查点耗时、重启时间和中断造成的工作损失。把交互式与可恢复工作负载分开统计,比较才成立。
通过运营指标确认抢占原因
Ai2 的报告没有公开用于检查的命令或配置键。因此检查只能停留在运营指标层面。
对类似政策来说,首要检查点似乎是能否在同一视图中看到各组的已交付与配额时间、作业变为可抢占的时刻以及被计费的预算。
谁来分配预算、份额不足时如何申诉,同样重要。即使公式透明,若分配决策不透明,也难以建立运营上的信任。
98% 无法说明的内容
这里有三个独立的问题:可用硬件是否已分配,各组是否拿到了应得时间,这些时间是否转化为有用计算。
占用率回答第一个,以需求为上限的交付率回答第二个。两者都不能证明第三个,本文也没有复现 Ai2 的调度器或模拟。
比起集群满载,抢占之后仍能保留的进展才是这个调度器真正的成绩单。