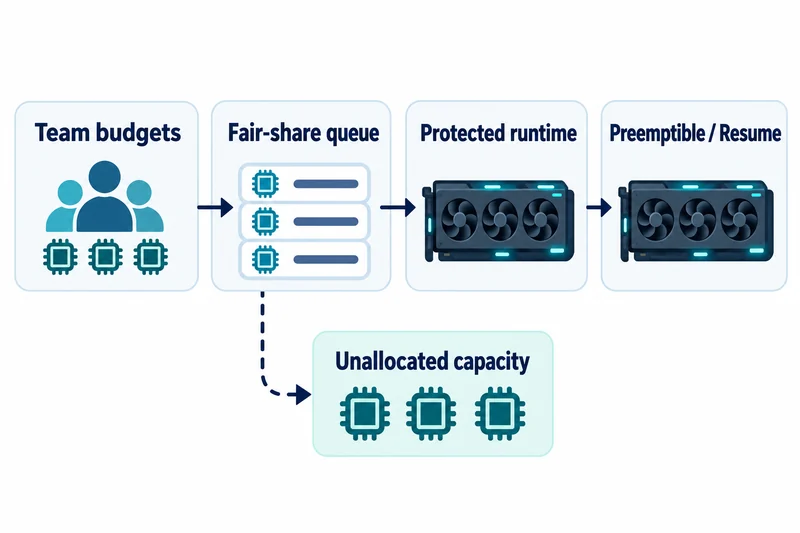
Ai2は10月9日の報告で、GPUクラスタのスケジューラーを置き換えた結果を公開した。優先度ベースのスケジューラーを、GPU時間予算、階層型フェアシェア、タイムスライスの契約に替えた構成だ。
展開は7月末からクラスタごとに進み、報告された30日間でチームは配分されるべきGPU時間の98%を受け取った。配分されるべき時間とは、1時間ごとに実需要を上限とした割り当て量である。
クラスタ占有率は変更前後とも98%だった。運営者による観測であり、独立したベンチマークではない。
出発点は旧方式のボトルネックだった。需要が供給の2〜3倍ある中で、コストのかからないHIGH優先度が最終的に全ジョブの100%に広がり、空のジョブでGPUを確保し続ける利用者も出た。
マシンではなく時間を分ける階層型フェアシェア
Ai2の解決策は、チームにGPUを渡す代わりにGPU時間の取り分を配分することだ。管理者がプロジェクトと研究者へ予算を比率で分け、スケジューラーは既定7日間のスライディング参照期間で占有を追跡する。
配分より使用が少ないグループのジョブが、多く使ったグループより前に並ぶ。時間予算は一定期間の利用権であり、同じ装置を継続して予約するものではない。
アルゴリズム自体は新しくないとAi2も述べている。SlurmのFair Treeは、アカウントツリーで同じ親の下にある兄弟間の取り分と使用量を比較する。
Ai2はこの系譜に触れただけで、自社スケジューラーがSlurmの実装を動かしている根拠はない。
最小実行時間の契約とプリエンプションの境界
ジョブは投入時に、意味のある進捗に必要な最小実行時間を申告し、その間はプリエンプションから保護される。Ai2が定めた保護の上限は8時間だ。
保護期間が終わると、再開可能なジョブは自動的にキューへ戻る。最小値を0にすると、どの予算にも課金されない未割り当て時間となり、最初からプリエンプト対象になる。
この契約により、不調なホストもジョブが最小実行時間に達した時点で自動的に空けられるようになった。Ai2は人手を要する修理が74%減ったと報告している。
一方、揮発的な対話セッションは8時間の保護後にプリエンプトされると、状態を手作業で作り直す必要があった。Ai2は最大規模のジョブの待ち時間を延ばし得る容量の断片化も調査中だ。
保護期間の長さと再起動コストのトレードオフ
設計上の問題は、復旧可能な作業単位をどの大きさにするかだ。期間が短ければ再配分の機会は増えるが、再起動のたびに進捗を捨てるなら、その機会の価値は下がる。
長い期間はジョブに進捗の余裕を与える一方、同じハードウェアを待つ他のジョブを遅らせる。占有率の数字だけでは、どちらが適切か決めにくいように見える。
現実的な試行では、キュー待ち時間の横にチェックポイント所要時間、再起動時間、中断で失った作業を記録する。対話型と再開可能なワークロードを分けて集計してこそ、比較が成り立つ。
運用指標でプリエンプション理由を確かめる方法
Ai2の報告は、確認用のコマンドや設定キーを公開していない。そのため確認は運用指標のレベルにとどまる。
同様の方針なら、グループごとの配分対提供時間、ジョブがプリエンプト可能になった時点、課金された予算を一つの画面で見られるかが最初の確認点に見える。
誰が予算を配分し、不足した取り分にどう異議を申し立てるかも同じ重みを持つ。式が透明でも配分の決定が不透明なら、運用上の信頼は生まれにくい。
98%が示さないこと
ここでは三つの問いが分かれる。利用可能なハードウェアが割り当てられたか、各グループが受け取るべき時間を受け取ったか、その時間が有用な計算につながったかだ。
占有率は一つ目に、需要を上限とした提供率は二つ目に答える。どちらも三つ目を証明せず、本記事はAi2のスケジューラーやシミュレーションを再現していない。
クラスタが埋まっていることより、プリエンプション後にも残る進捗こそがこのスケジューラーの本当の成績表だ。