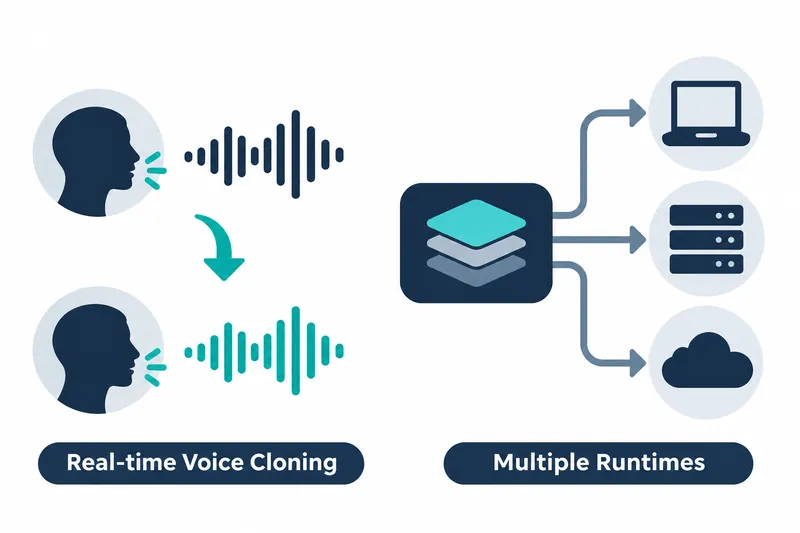
Zyphra가 11월 9일 실시간 음성 복제 모델 ZONOS3-Mini를 공개했다. 개발자는 짧은 음성 샘플을 바탕으로 목소리를 복제하고, 브라우저·개인 기기·서버 가운데 배포 환경을 선택해 음성을 만들 수 있다.
1. 필요한 일부만 계산해 기기 내 실행을 겨냥
모델은 전체 8억 파라미터 가운데 토큰을 만들 때 약 1억 개만 활성화한다. 필요한 부분만 골라 계산하는 혼합 전문가 구조로, 큰 모델의 일부를 동원해 음성을 만드는 방식이다.
모델 카드에 따르면 한국어를 포함한 43개 언어를 지원하며 가중치 라이선스는 Apache 2.0이다.
회사는 이전 ZONOS2가 80억 파라미터와 초당 86프레임 코덱을 사용해 배포에 제약이 있었다고 설명한다. 새 버전은 소리를 압축해 표현하는 자체 코덱 ZAC-1으로 초당 15프레임을 생성하고 이를 44.1kHz 오디오로 변환한다.
회사 발표 기준 비슷한 데이터 조건에서 ZAC-1을 적용한 모델의 단어 오류율, 음성 인식에서 틀린 단어의 비율은 DAC 적용 모델보다 10배 낮았고, 음향 유사도, 두 소리가 닮은 정도도 더 높았다. 처리할 소리 표현을 줄이면서 발음의 정확도를 높였다는 것이 회사가 제시한 개선 방향이다.
2. 브라우저의 응답 속도와 서버의 처리 능력
회사 발표 기준 WebGPU로 실행한 브라우저에서 첫 음성이 나올 때까지 걸린 시간은 Pixel 9에서 570밀리초 미만, M3 MacBook Air에서 150밀리초 미만이다. 휴대전화와 노트북에서도 음성 생성을 시작하는 대기 시간을 짧게 가져가는 것이 목표다.
서버 결과는 모델 카드에 제시된 회사 발표 기준으로, NVIDIA H100 80GB 한 장에 화자 음성의 특징을 요약한 표현을 입력해 측정했다. 동시 요청 8개에서 첫 음성까지 걸린 시간의 중앙값, 측정값을 크기순으로 놓았을 때 가운데 값은 80밀리초다.
모델별 최적 동시성, 동시에 처리하는 작업 수에서 측정한 피크 처리량, 가장 높은 오디오 처리량은 초당 오디오 457초로, 응답 시작 속도와 별도로 여러 요청을 처리하는 능력을 보여 준다.
평가 체계도 함께 공개했다. ZTTS2-Eval은 읽기 음성 35개 언어와 실제 환경 녹음 20개 언어를 다루며, 이를 활용해 420개 항목으로 구성한 지표를 만들었다. 이 회사 평가 기준 ZONOS3-Mini는 오픈 모델 가운데 1위였다.
회사 발표 기준 그다음 순위는 Fish S2 Pro, MOSS TTS v1.5 순이었다. 언어별 정확도뿐 아니라 목소리 유사도와 리듬·음높이 등도 평가에 반영한다.
3. 브라우저 체험부터 서버 연동까지 경로 선택
WebGPU 지원 브라우저에서는 사용자 기기로 실행하며 별도 설치와 서버가 필요 없다. 내려받은 모델은 브라우저 캐시에 보관해 다음 방문에도 이용한다.
음성 제작용 Zonos Voice Studio와 빠른 음성 복제를 위한 Lite도 마련했다.
서버에서는 SGLang-Omni가 OpenAI 호환 음성 API와 스트리밍을 지원하며, 참조 음성에 자막이 없어도 복제할 수 있다.
회사 자체 런타임은 엔비디아 그래픽카드용 CUDA와 애플 칩용 MLX를 제공한다.
C++/ggml 기반 서버와 명령줄 도구도 마련했으며, 자체 런타임은 공통 HTTP API를 공유한다. 개발자는 실행 환경이 바뀌어도 공통된 연동 방식을 활용할 수 있다.
브라우저 경로는 별도 서버를 마련하는 부담을 줄이는 대신, 첫 방문 때 모델을 내려받고 사용자 기기의 그래픽 처리 장치가 계산을 맡는다.
파이썬 라이브러리에서 참조 음성을 불러와 화자 정보를 만들고 음성을 생성하는 예시는 다음과 같다.
import torchaudio
from zonos.model import Zonos
from zonos.conditioning import make_cond_dict
model = Zonos.from_pretrained("Zyphra/ZONOS3-Mini", device="cuda")
wav, sr = torchaudio.load("speaker.wav")           # 5-10s reference clip
speaker = model.make_speaker_embedding(wav, sr)
cond  = make_cond_dict(text="Hello, world!", speaker=speaker, language="en-us")
codes = model.generate(model.prepare_conditioning(cond))
audio = model.autoencoder.decode(codes)[0].cpu()
torchaudio.save("sample.wav", audio, model.autoencoder.sampling_rate)
4. 목소리와 단어별 전달 방식을 함께 조정
사용자는 나이·성별·억양·음질 같은 목소리 특성과 빠르기·감정·활기를 조정할 수 있다. 가까이 말하는 느낌과 방 건너로 외치는 느낌처럼 목소리를 보내는 강도도 바꿀 수 있다.
생성 중에는 단어 단위 전달 방식을 제어하고, 생성이 끝난 뒤에는 편집 모델로 문장을 수정할 수 있다. 게임 캐릭터나 내레이션에서는 목소리를 고른 뒤 특정 구절의 연기까지 다듬는 데 활용할 수 있다.
회사 설명에 따르면 조정값은 실제 나이나 감정의 측정값이 아닌 생성 목표이며, 빠르기나 활기를 바꾸면 음량·음높이·길이도 함께 달라질 수 있다. 숨 섞인 질감은 전용 조정 기능 대신 부드러운 음질로 근사한다.
ZONOS3-Mini의 핵심은 작은 활성 모델과 복수 실행 경로로 실시간 음성 복제를 개발자의 배포 환경 가까이 가져온 데 있다.