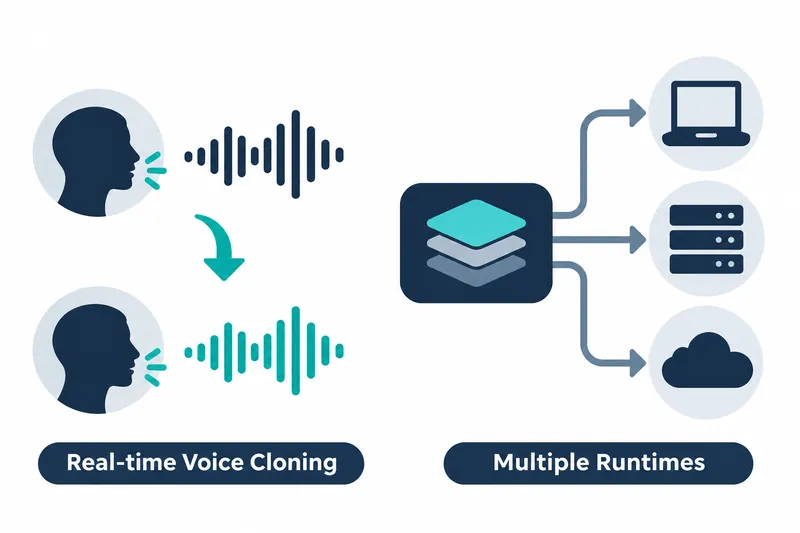
Zyphraが11月9日、リアルタイム音声クローンモデルZONOS3-Miniを公開した。開発者は短い音声サンプルを基に声を複製し、ブラウザー・個人端末・サーバーから導入環境を選んで音声を生成できる。
1. 必要な一部だけを計算し、端末内実行を狙う
モデルは全8億パラメーターのうち、トークン生成時に約1億個だけを有効化する。必要な部分だけを選んで計算する混合エキスパート構造で、大きなモデルの一部を使って音声を生成する仕組みだ。
モデルカードによると、韓国語を含む43言語に対応し、重みのライセンスはApache 2.0だ。
同社は、従来のZONOS2は80億パラメーターと毎秒86フレームのコーデックを使用し、導入に制約があったと説明する。新版は音を圧縮して表現する独自コーデックZAC-1で毎秒15フレームを生成し、44.1kHzの音声に変換する。
同社発表では、同程度のデータ条件でZAC-1を適用したモデルの単語誤り率、つまり音声認識で誤った単語の割合は、DAC適用モデルの10分の1で、音響類似度、つまり2つの音の似ている度合いも高かった。処理する音の表現を減らしつつ発音精度を高めたというのが、同社の示す改善の方向だ。
2. ブラウザーの応答速度とサーバーの処理能力
同社発表では、WebGPUで実行したブラウザーで最初の音声が出るまでの時間は、Pixel 9で570ミリ秒未満、M3 MacBook Airで150ミリ秒未満だ。携帯電話やノートパソコンでも、音声生成を開始するまでの待ち時間を短くすることを目指す。
サーバーの結果はモデルカードに記載された同社発表値で、NVIDIA H100 80GBを1枚使用し、話者の声の特徴を要約した表現を入力して測定した。同時リクエスト8件で最初の音声までの時間の中央値、つまり測定値を大きさ順に並べた中央の値は80ミリ秒だ。モデルごとの最適な同時実行数、つまり同時に処理する作業数で測ったピーク処理量、つまり最大の音声処理量は毎秒457秒分の音声で、応答開始の速さとは別に複数リクエストを処理する能力を示す。
評価体系も併せて公開した。ZTTS2-Evalは35言語の読み上げ音声と20言語の実環境録音を扱い、これを使って420項目からなる指標を作成した。同社の評価では、ZONOS3-Miniはオープンモデルの中で1位だった。
同社発表では、その次はFish S2 Pro、MOSS TTS v1.5の順だった。言語ごとの正確さだけでなく、声の類似度やリズム・音高なども評価に反映する。
3. ブラウザーでの体験からサーバー連携まで経路を選択
WebGPU対応ブラウザーではユーザーの端末上で実行し、別途インストールやサーバーは必要ない。ダウンロードしたモデルはブラウザーのキャッシュに保存し、次回の訪問時も利用する。
音声制作用のZonos Voice Studioと、手軽に音声を複製するためのLiteも用意した。
サーバーではSGLang-OmniがOpenAI互換の音声APIとストリーミングに対応し、参照音声に字幕がなくても複製できる。
同社独自のランタイムは、NVIDIA製グラフィックスカード向けのCUDAとApple製チップ向けのMLXを提供する。
C++/ggmlベースのサーバーとコマンドラインツールも用意し、独自ランタイムは共通のHTTP APIを共有する。開発者は実行環境が変わっても共通の連携方式を利用できる。
ブラウザー経由では別途サーバーを用意する負担が減る一方、初回訪問時にモデルをダウンロードし、ユーザー端末のGPUが計算を担う。
Pythonライブラリで参照音声を読み込み、話者情報を作成して音声を生成する例は次のとおりだ。
import torchaudio
from zonos.model import Zonos
from zonos.conditioning import make_cond_dict
model = Zonos.from_pretrained("Zyphra/ZONOS3-Mini", device="cuda")
wav, sr = torchaudio.load("speaker.wav")           # 5-10s reference clip
speaker = model.make_speaker_embedding(wav, sr)
cond  = make_cond_dict(text="Hello, world!", speaker=speaker, language="en-us")
codes = model.generate(model.prepare_conditioning(cond))
audio = model.autoencoder.decode(codes)[0].cpu()
torchaudio.save("sample.wav", audio, model.autoencoder.sampling_rate)
4. 声と単語ごとの発話表現を併せて調整
ユーザーは年齢・性別・アクセント・声質といった声の特徴や、速さ・感情・活気を調整できる。近くで話す感じや部屋の向こうへ叫ぶ感じなど、声を届ける強さも変えられる。
生成中は単語単位の発話表現を制御し、生成後は編集モデルで文を修正できる。ゲームのキャラクターやナレーションでは、声を選んだ後に特定のフレーズの演技まで磨く用途に活用できる。
同社の説明では、調整値は実際の年齢や感情の測定値ではなく生成目標であり、速さや活気を変えると音量・音高・長さも一緒に変化する場合がある。息の混じった質感は、専用の調整機能ではなく柔らかな声質で近似する。
ZONOS3-Miniの核心は、有効化するモデルの規模を小さくし、複数の実行経路を用意することで、リアルタイム音声クローンを開発者の導入環境に近づけた点にある。