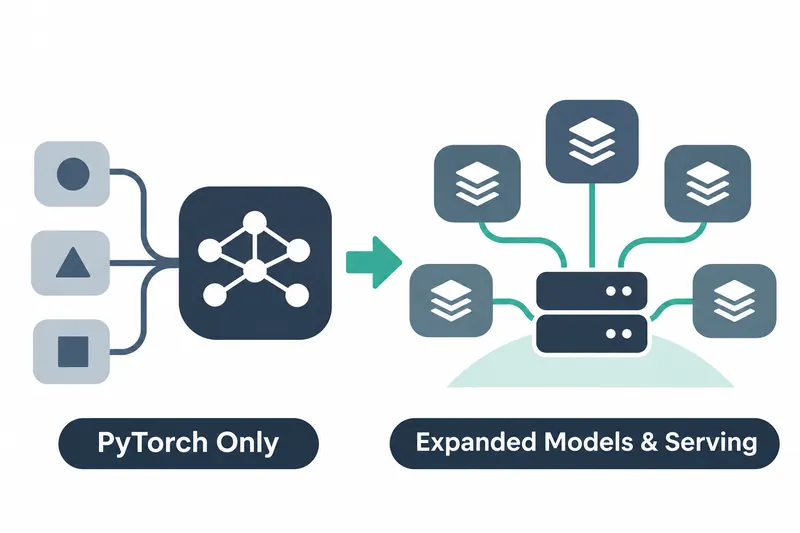
TensorRT-LLM은 대규모 언어 모델의 추론을 실행하고 서비스 요청에 응답하도록 제공하는 NVIDIA의 소프트웨어다. 1.3.0은 실행 기반을 PyTorch 하나로 통일하고 이미지·영상 생성까지 같은 서빙 도구로 제공한다. 모델을 서비스에 연결하는 개발자에게는 텍스트 추론 외에 생성 모델까지 선택 범위가 넓어진다.
1. 엔진 빌드 대신 PyTorch 실행으로 통일
이번 버전은 엔진을 미리 빌드해 실행하던 기반을 없애고 실행 방식을 하나로 통일했다. 엔진 빌드 명령과 관련 설정 객체도 빠졌고, Triton 백엔드 모델은 llmapi만 남았다.
기존 C++ 실행기 API도 제거됐다. 실행 환경을 다루던 레거시 런타임 API와 요청을 묶어 처리하던 배치 관리자 API 역시 제거 대상이다. 기존 엔진이나 C++ 실행기에 맞춘 배포 자동화는 PyTorch 실행 방식으로 이관해야 한다.
다음 토큰을 고르는 샘플러는 FlashInfer가 필요한 TorchSampler만 지원한다. 기존 샘플러를 고르는 대신 이 조합을 사용하는 방식으로 정리됐다.
TensorRT와 ONNX가 필수 의존성에서 빠져 설치·실행에 필요한 외부 구성 요소가 줄었다.
회사 발표 기준으로 입력 준비를 비동기로 처리하고 후보 문장을 나눠 탐색하는 빔 서치에서 동기화를 없애 CPU 측의 부가 처리 부담을 줄였다.
체크포인트 데이터를 미리 읽어 두는 선읽기는 회사 발표 기준으로 시작 시간을 줄였다. 이는 실행 중 처리 부담을 줄이는 개선과 구분된다.
2. 새 모델과 기존 GPU의 활용 범위 확대
DeepSeek-V4와 Kimi K3가 Blackwell 및 미리보기 단계의 Rubin 지원 목록에 추가됐다. 반면 Qwen3.5는 Hopper에서도 지원돼 기존 GPU를 활용하는 경로를 제공한다. Kimi K3는 여러 형태의 입력을 함께 다루는 멀티모달 기능과 여러 노드에 걸친 서빙도 지원한다.
Rubin 지원은 Vera Rubin에서 검증한 미리보기로 제공된다. 차세대 하드웨어용 배포를 시험하는 단계의 지원이다.
양자화는 수치 표현의 정밀도를 낮추는 방식이다. 이번에는 모델이 학습한 수치 정보인 가중치만 낮은 정밀도로 저장하는 W4A16 NVFP4 방식을 Marlin으로 지원한다. 이 경로를 통해 NVFP4 가중치 체크포인트를 Hopper와 Ada Lovelace에서도 실행할 수 있다. 새 하드웨어용 미리보기와 달리 기존 GPU에서 NVFP4 체크포인트를 활용하는 경로다.
모델의 여러 하위 신경망 가운데 일부를 골라 계산하는 MoE는 최대 2048개의 전문가망을 지원한다.
이와 별개로 토큰별로 어느 전문가망에 계산을 맡겼는지 반환하는 기능도 추가됐다. 이 정보는 보상에 따라 행동을 학습하는 강화학습에 활용할 수 있다.
3. API 연결과 분리 서빙의 선택지 확대
Anthropic Messages API가 추가되고 Responses API가 확장됐다. OpenAI 호환 API에서는 요청마다 우선순위와 호출할 함수를 지정할 수 있다.
gRPC 원격 호출 서버와 요청을 받아 전달하는 다중 프로세스 HTTP 프런트엔드도 추가됐다.
입력 처리와 출력 생성을 나눠 맡기는 분리 서빙에는 생성 우선 스케줄링과 같은 대화의 요청을 모아 보내는 라우팅이 들어갔다. KV 캐시는 이전 입력에서 계산한 정보를 저장해 이후 생성에 재사용하는 장치다. 이번 버전에는 대화별 캐시 블록 재사용도 추가됐다. API 확장이 서비스의 접속 규격을 넓힌다면, 대화별 라우팅과 블록 재사용은 이어지는 대화의 요청을 모으고 이전 계산을 활용하는 내부 처리 구성에 영향을 준다.
공통된 앞부분을 가진 입력은 기본으로 켜지는 접두부 인식 스케줄링의 대상이다. 공유 접두부를 중복으로 입력 처리하지 않도록 하므로, API 종류뿐 아니라 반복되는 입력을 처리하는 동작도 달라진다.
인코더 전용 모델, 입력을 벡터로 바꾸는 부분만 쓰는 모델에는 임베딩 API와 llm.encode() 빠른 경로가 마련됐다. 검색용 임베딩을 제공하는 서비스도 이번 확장의 대상이다.
4. 이미지·영상 생성도 같은 서빙 체계로
VisualGen은 이미지와 영상 생성 모델을 위한 기능 묶음으로, LLM 추론과 함께 trtllm-serve에서 제공된다. 이미지 생성·편집과 영상 생성에 각각 접속 경로가 추가돼, 같은 서빙 도구를 쓰면서도 서비스가 제공할 생성 작업에 맞춰 호출 경로를 구성할 수 있다.
이미지 모델에는 FLUX.1과 FLUX.2가, 영상 모델에는 Wan 2.2와 LTX-2 등이 추가됐다. 텍스트 응답뿐 아니라 이미지 편집·영상 생성도 접속 경로로 제공할 수 있다는 점에서 서비스 구성의 범위가 넓어졌다.
5. 업그레이드는 설정 우선순위와 기본값부터 확인
실행 기반에서는 TensorRT 백엔드가 제거되고 PyTorch만 남았다. Triton에서도 TensorRT 엔진 기반 모델은 제거돼 llmapi 모델만 사용할 수 있다.
서빙·평가·벤치마크 명령에서 명시한 플래그, 명령 실행 때 값을 지정하는 옵션은 이제 YAML 설정값보다 우선한다. 같은 설정 파일을 재사용하는 배포라도 실행 명령에 지정한 값부터 확인할 필요가 있다.
KV 캐시 전송에는 기본 60초의 대기 한도가 생겼고 이전에는 제한 시간이 없었다. 따라서 전송이 지연될 때 요청 처리가 무기한 기다리던 동작에서 정해진 대기 한도를 적용하는 동작으로 바뀐다.
이 전송 대기 한도와 별개로, 요청 설정에서는 logprobs와 prompt_logprobs가 100을 넘기면 오류를 낸다. 이는 처리 속도가 아니라 해당 요청에서 허용하는 설정값의 상한이다.
요청별 대화 템플릿은 명시적으로 허용해야 사용할 수 있다.
사용 텔레메트리, 사용 현황을 수집해 보내는 계측 정보는 기본으로 켜진다. 아래는 원문에 제시된 해제 방법으로 이 중 하나를 선택하면 된다.
TRTLLM_NO_USAGE_STATS=1
DO_NOT_TRACK=1
--no-telemetry
telemetry_config=TelemetryConfig(disabled=True)
알려진 문제로는 NVIDIA Model Optimizer로 정적 양자화, 변환 시 정밀도를 미리 낮추는 방식으로 내보낸 FLUX.1 체크포인트가 초기화에 실패할 수 있다는 점이 있다. Responses API에도 일부 입력 형식과 대화 이어가기·도구 호출의 호환성 공백이 남아 있다.
이번 릴리스의 도입 판단은 늘어난 모델 목록보다 기존 배포 경로가 PyTorch 전환을 얼마나 쉽게 수용할 수 있는지에서 출발하는 편이 맞다.