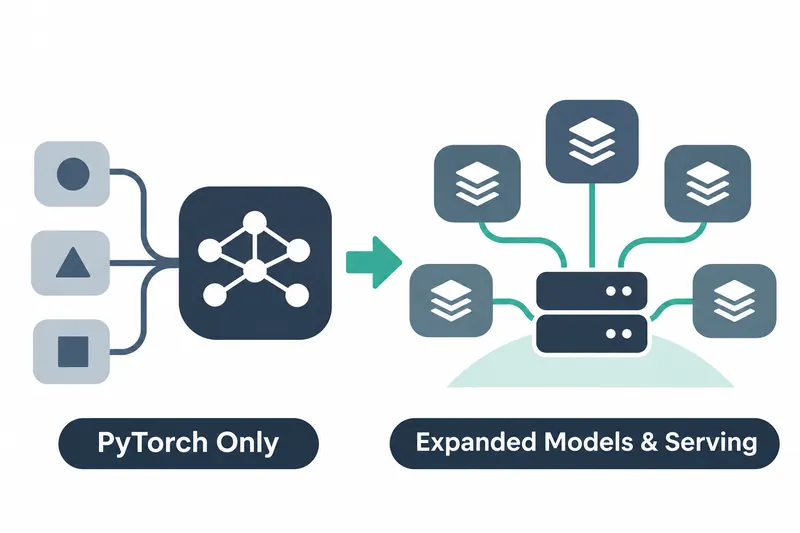
TensorRT-LLMは、大規模言語モデルの推論を実行し、サービスへのリクエストに応答するためのNVIDIAのソフトウェアだ。1.3.0は実行基盤をPyTorchに一本化し、画像や動画の生成も同じサービングツールで提供する。モデルをサービスに接続する開発者には、テキスト推論に加えて生成モデルまで選択肢が広がる。
1. エンジンのビルドからPyTorch実行へ統一
今回のバージョンは、エンジンを事前にビルドして実行していた基盤を廃止し、実行方式を一本化した。エンジンのビルドコマンドと関連する設定オブジェクトも削除され、Tritonバックエンドのモデルはllmapiだけとなった。
従来のC++エグゼキューターAPIも削除された。実行環境を扱うレガシーランタイムAPIと、リクエストをまとめて処理するバッチマネージャーAPIも削除対象だ。従来のエンジンやC++エグゼキューターに合わせたデプロイの自動化は、PyTorchの実行方式に移行する必要がある。
次のトークンを選ぶサンプラーは、FlashInferを必要とするTorchSamplerのみをサポートする。従来のサンプラーを選ぶ代わりに、この組み合わせを使う方式に整理された。
TensorRTとONNXが必須依存関係から外れ、インストールと実行に必要な外部コンポーネントが減った。
同社の発表によると、入力準備の非同期処理と、候補文を分けて探索するビームサーチでの同期の廃止により、CPU側の付加的な処理負荷を削減した。
チェックポイントのデータを事前に読み込む先読みは、同社の発表によると起動時間を短縮した。これは実行中の処理負荷を減らす改善とは区別される。
2. 新モデルと既存GPUの活用範囲を拡大
DeepSeek-V4とKimi K3が、Blackwellおよびプレビュー段階のRubinのサポート対象に追加された。一方、Qwen3.5はHopperにも対応し、既存GPUを活用する経路を提供する。Kimi K3は、複数の形式の入力を扱うマルチモーダル機能と、複数ノードにまたがるサービングにも対応する。
Rubin対応は、Vera Rubinで検証したプレビューとして提供される。次世代ハードウェア向けのデプロイを試す段階のサポートだ。
量子化とは、数値表現の精度を下げる手法だ。今回は、モデルが学習した数値情報である重みのみを低精度で保存するW4A16 NVFP4方式を、Marlinでサポートする。この経路により、NVFP4重みのチェックポイントをHopperとAda Lovelaceでも実行できる。新ハードウェア向けのプレビューとは異なり、既存GPUでNVFP4チェックポイントを活用する経路だ。
モデルの複数のサブネットワークから一部を選んで計算するMoEは、最大2048のエキスパートネットワークに対応する。
これとは別に、トークンごとにどのエキスパートネットワークに計算を割り当てたかを返す機能も追加された。この情報は、報酬に応じて行動を学ぶ強化学習に活用できる。
3. API接続と分離サービングの選択肢を拡充
Anthropic Messages APIが追加され、Responses APIが拡張された。OpenAI互換APIでは、リクエストごとに優先度と呼び出す関数を指定できる。
gRPCリモート呼び出しサーバーと、リクエストを受けて転送するマルチプロセスHTTPフロントエンドも追加された。
入力処理と出力生成を分けて担う分離サービングには、生成優先のスケジューリングと、同じ対話のリクエストをまとめて送るルーティングが加わった。KVキャッシュは、以前の入力で計算した情報を保存し、後の生成に再利用する仕組みだ。今回は対話ごとのキャッシュブロック再利用も追加された。API拡張がサービスの接続仕様を広げる一方、対話別ルーティングとブロック再利用は、続く対話のリクエストを集めて以前の計算を活用する内部処理構成に影響する。
共通の先頭部分を持つ入力は、デフォルトで有効なプレフィックス認識スケジューリングの対象となる。共有プレフィックスの入力処理の重複を防ぐため、APIの種類だけでなく、繰り返される入力を処理する動作も変わる。
エンコーダー専用モデル、つまり入力をベクトルに変換する部分だけを使うモデルには、埋め込みAPIとllm.encode()の高速経路が用意された。検索用の埋め込みを提供するサービスも、今回の拡張の対象だ。
4. 画像と動画の生成も同じサービング基盤で
VisualGenは画像と動画の生成モデル向けの機能群で、LLM推論とともにtrtllm-serveで提供される。画像の生成・編集と動画生成にそれぞれ接続経路が追加され、同じサービングツールを使いながら、サービスで提供する生成タスクに合わせて呼び出し経路を構成できる。
画像モデルにはFLUX.1とFLUX.2が、動画モデルにはWan 2.2やLTX-2などが追加された。テキスト応答だけでなく、画像編集や動画生成も接続経路として提供できる点で、サービス構成の範囲が広がった。
5. アップグレードは設定の優先順位とデフォルト値から確認
実行基盤ではTensorRTバックエンドが削除され、PyTorchのみが残った。TritonでもTensorRTエンジンベースのモデルは削除され、llmapiモデルのみ利用できる。
サービング・評価・ベンチマークのコマンドで明示したフラグ、つまりコマンド実行時に値を指定するオプションは、YAMLの設定値より優先されるようになった。同じ設定ファイルを再利用するデプロイでも、実行コマンドで指定した値から確認する必要がある。
KVキャッシュの転送には、デフォルトで60秒の待機上限が設けられた。以前はタイムアウトがなかった。そのため、転送が遅延した際のリクエスト処理は、無期限に待機する動作から、所定の待機上限を適用する動作に変わる。
この転送の待機上限とは別に、リクエスト設定ではlogprobsとprompt_logprobsが100を超えるとエラーになる。これは処理速度ではなく、そのリクエストで許容する設定値の上限だ。
リクエストごとの対話テンプレートは、明示的に許可しなければ使用できない。
利用テレメトリー、つまり利用状況を収集して送信する計測情報は、デフォルトで有効になる。以下は原文で示された無効化の方法で、このうち1つを選べばよい。
TRTLLM_NO_USAGE_STATS=1
DO_NOT_TRACK=1
--no-telemetry
telemetry_config=TelemetryConfig(disabled=True)
既知の問題として、NVIDIA Model Optimizerで静的量子化、つまり変換時にあらかじめ精度を下げる方式でエクスポートしたFLUX.1チェックポイントは、初期化に失敗する場合がある。Responses APIにも、一部の入力形式や、対話の継続・ツール呼び出しの互換性に未対応の部分が残る。
今回のリリースの導入判断は、増えたモデル一覧よりも、既存のデプロイ経路がPyTorchへの移行をどれだけ容易に受け入れられるかを出発点にするのが適切だ。