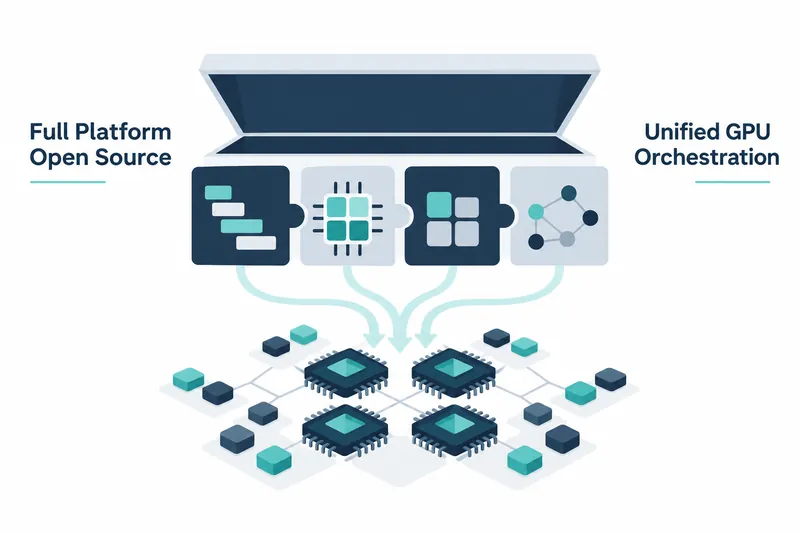
NVIDIA가 여러 팀의 인공지능 작업에 GPU를 나눠 주는 플랫폼 전체 코드를 공개했다. 공유 인프라를 만드는 개발팀은 작업 배치부터 조직별 자원 배분까지 코드를 검토하고 수정하거나, 필요한 기능만 기존 환경에 붙일 수 있게 됐다.
1. 스케줄러에서 전체 플랫폼으로 넓어진 공개
NVIDIA는 2026년 10월 13일 Run:ai 전체 플랫폼의 오픈소스 공개를 발표했다. 기존에 공개한 작업 배치 엔진을 넘어, 추가 플랫폼 코드와 독립적으로 도입할 수 있는 네 구성 요소를 제공한다. 이번 공개는 NVIDIA DSX AI Factory Platform의 일부다.
통합 저장소에는 중앙 관리 계층과 클러스터 서비스, 설치 도구와 개발 환경이 들어 있다. 저장소 코드는 Apache 2.0을 따르지만, 일부 하위 디렉터리의 제삼자 코드와 자산에는 별도 라이선스가 적용된다.
2. 배치·분할·조직·작업 정의의 역할 분리
KAI Scheduler는 어느 GPU에 작업을 놓을지 결정한다. 여러 실행 단위가 함께 필요한 작업은 전부 배치하거나 전혀 배치하지 않도록 메모리에서 먼저 배치 가능성을 검증한다. 팀별로 자원을 공정하게 나누고, 장치 간 연결 구조를 고려하며, 기존 스케줄러와 함께 실행할 수 있다.
GPU Fractioning Operator는 GPU 한 장을 여러 작업이 나눠 쓰도록 노드 구성 요소를 관리한다. 기존 독자 구현은 CUDA 13.4의 기본 분할 기능으로 대체됐다. 드라이버가 작업별 GPU 메모리 상한을 강제하며, 상한을 넘으면 해당 컨테이너가 메모리 부족으로 종료된다.
KAI Resource Management는 부서와 프로젝트별로 누가 얼마를 쓸지 정한다. 조직 계층에 따라 GPU 용량을 배분·보장·공유하고, 서로 다른 하드웨어를 묶어 작업에 맞는 자원을 지정한다.
Workload Map은 작업 종류마다 다른 구조와 역할, 상태를 공통 방식으로 설명하는 규약이다. 도구마다 별도 해석기를 만드는 대신 함께 쓰는 작업 설명서에 가깝다. 클러스터에 추가 설치 없이 쓰는 Go 라이브러리이며, 직접 작업을 배치하거나 대기열과 자동 확장을 관리하지는 않는다.
3. 통합 설치와 로컬 검토 경로
전체 플랫폼은 직접 도입하거나 생태계 파트너 제품을 통해 사용할 수 있다. NVIDIA NGC에는 통합 설치용 Helm 차트를 포함한 커뮤니티 제품도 제공된다. 소스 코드의 오픈소스 라이선스와 달리, 이 제품 다운로드에는 NVIDIA 소프트웨어 라이선스 계약과 인공지능 제품별 약관 동의가 필요하다.
통합 저장소의 다음 예시는 로컬 검토용이다. 소스에서 서비스를 빌드해 로컬 쿠버네티스 클러스터에 배포한다. 컨테이너 실행 도구 등 선행 도구와 자원은 미리 준비해야 하며, 일부 클러스터 도구만 자동 설치된다.
./local-dev.sh                                  # full build + cluster + deploy
./local-dev.sh --skip-build --skip-cluster      # re-deploy only
./local-dev.sh --teardown                       # tear the environment down
4. GPU 분할은 소프트웨어 조합 확인부터
분할 오퍼레이터 문서는 NVIDIA GPU Operator v26.7.1을 권장한다. 필요한 컨테이너 도구와 장치 플러그인이 기본으로 포함되지만, GPU 노드 드라이버는 r615 이상으로 별도 지정해야 한다. 컨테이너 실행 환경 등 나머지 사전 조건도 저장소에서 확인해야 한다.
GPU 설정 도구가 자체 노드 연동 플러그인 모드로 동작하고 분할 오퍼레이터가 다른 네임스페이스에 설치됐다면, 관리자가 도구의 네임스페이스 허용 목록을 확장해야 한다. 여기서 네임스페이스는 클러스터 안의 작업 공간을 구분하는 단위다.
버전 검증을 끄는 설정은 호환성을 만들어 주지 않는다. 지원하지 않는 GPU 소프트웨어 조합에서도 준비 완료로 표시될 수 있으며, 메모리 상한이 강제되지 않아도 문제가 보고되지 않을 수 있다.
5. 선택의 이익과 운영의 비용
전체 플랫폼과 개별 기능을 고를 수 있다는 점은 기존 환경을 유지하려는 팀에 유리하다. 반면 직접 운영하면 소프트웨어 조합과 노드 구성 요소를 관리할 부담이 따른다. 커뮤니티 제품은 유료 구독이나 지원 권한 없이 쓸 수 있지만 기업용 지원은 포함하지 않으므로, 지원이 필요하면 상용 제공 경로의 조건을 따로 검토해야 한다.
저장소는 한 팀이 전용 GPU로 작업만 실행한다면 기본 쿠버네티스 스케줄링으로 충분할 수 있다고 설명한다. 여러 팀의 자원 공유와 할당량 통제가 필요한지가 도입 범위를 정하는 기준이다.
이번 공개의 가치는 공유 GPU 운영에 필요한 기능을 골라 쓸 수 있다는 데 있으며, 도입 범위는 조직별 자원 통제 필요와 직접 운영할 역량에 맞춰 정해야 한다.