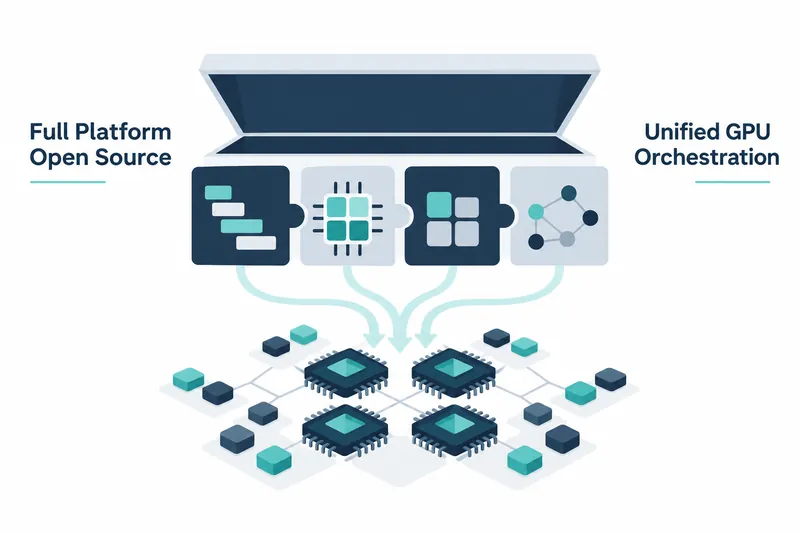
NVIDIAが複数チームのAIワークロードにGPUを割り当てるプラットフォーム全体のコードを公開した。共有インフラを構築する開発チームは、ワークロード配置から組織別のリソース配分までコードを検討・修正したり、必要な機能だけを既存環境に組み込んだりできるようになった。
1. スケジューラーからプラットフォーム全体へ広がる公開範囲
NVIDIAは2026年10月13日、Run:aiプラットフォーム全体のオープンソース公開を発表した。従来公開していたワークロード配置エンジンに加え、追加のプラットフォームコードと、独立して導入できる4つの構成要素を提供する。今回の公開はNVIDIA DSX AI Factory Platformの一部だ。
統合リポジトリには中央管理層とクラスターサービス、インストールツールと開発環境が含まれる。リポジトリのコードはApache 2.0に従うが、一部のサブディレクトリにある第三者のコードやアセットには別のライセンスが適用される。
2. 配置・分割・組織・ワークロード定義の役割分担
KAI Schedulerは、どのGPUにワークロードを配置するかを決める。複数の実行単位を同時に必要とするワークロードは、すべて配置するか一切配置しないよう、メモリ上で事前に配置可能性を検証する。チーム間でリソースを公平に分け、デバイス間の接続構造を考慮し、既存のスケジューラーと併用できる。
GPU Fractioning Operatorは、1枚のGPUを複数のワークロードで共有するためのノード構成要素を管理する。従来の独自実装はCUDA 13.4の標準分割機能に置き換えられた。ドライバーがワークロードごとのGPUメモリ上限を強制し、上限を超えると該当コンテナがメモリ不足で終了する。
KAI Resource Managementは、部門やプロジェクトごとに誰がどれだけ使うかを決める。組織階層に沿ってGPU容量を配分・保証・共有し、異なるハードウェアをまとめてワークロードに合ったリソースを指定する。
Workload Mapは、ワークロードの種類ごとに異なる構造や役割、状態を共通の方法で記述する規約だ。ツールごとに個別の解釈処理を作る代わりに、共用するワークロードの説明書に近い。クラスターへの追加インストールなしで使えるGoライブラリであり、自らワークロードを配置したり、キューや自動スケーリングを管理したりはしない。
3. 統合インストールとローカルでの検討手順
プラットフォーム全体は直接導入するか、エコシステムパートナーの製品を通じて利用できる。NVIDIA NGCでは、統合インストール用のHelmチャートを含むコミュニティ製品も提供される。ソースコードのオープンソースライセンスとは異なり、この製品のダウンロードにはNVIDIAソフトウェアライセンス契約とAI製品別の規約への同意が必要だ。
統合リポジトリの次の例はローカルでの検討用だ。ソースからサービスをビルドし、ローカルのKubernetesクラスターにデプロイする。コンテナ実行ツールなどの前提ツールやリソースは事前に用意する必要があり、自動インストールされるのは一部のクラスターツールだけだ。
./local-dev.sh                                  # full build + cluster + deploy
./local-dev.sh --skip-build --skip-cluster      # re-deploy only
./local-dev.sh --teardown                       # tear the environment down
4. GPU分割はソフトウェアの組み合わせ確認から
分割オペレーターの文書ではNVIDIA GPU Operator v26.7.1を推奨している。必要なコンテナツールとデバイスプラグインは標準で含まれるが、GPUノードのドライバーはr615以上を別途指定する必要がある。コンテナ実行環境など、残りの前提条件もリポジトリで確認する必要がある。
GPU設定ツールが独自のノード連携プラグインモードで動作し、分割オペレーターが別の名前空間にインストールされている場合、管理者はツールの名前空間許可リストを拡張する必要がある。ここで名前空間とは、クラスター内の作業領域を区別する単位だ。
バージョン検証を無効にする設定は、互換性を生み出すものではない。サポート対象外のGPUソフトウェアの組み合わせでも準備完了と表示される場合があり、メモリ上限が強制されていなくても問題が報告されない可能性がある。
5. 選択の利点と運用のコスト
プラットフォーム全体と個別機能を選べる点は、既存環境を維持したいチームに有利だ。一方、自前で運用する場合はソフトウェアの組み合わせやノード構成要素を管理する負担が伴う。コミュニティ製品は有料サブスクリプションやサポートの権利なしで使えるが、企業向けサポートは含まれないため、必要な場合は商用提供の条件を別途検討する必要がある。
リポジトリでは、1つのチームが専用GPUでワークロードを実行するだけなら、Kubernetesの標準スケジューリングで十分な場合があると説明している。複数チーム間でのリソース共有と割り当て量の制御が必要かどうかが、導入範囲を決める基準となる。
今回の公開の価値は、共有GPUの運用に必要な機能を選んで使える点にあり、導入範囲は組織ごとのリソース制御の必要性と自前で運用する能力に合わせて決めるべきだ。