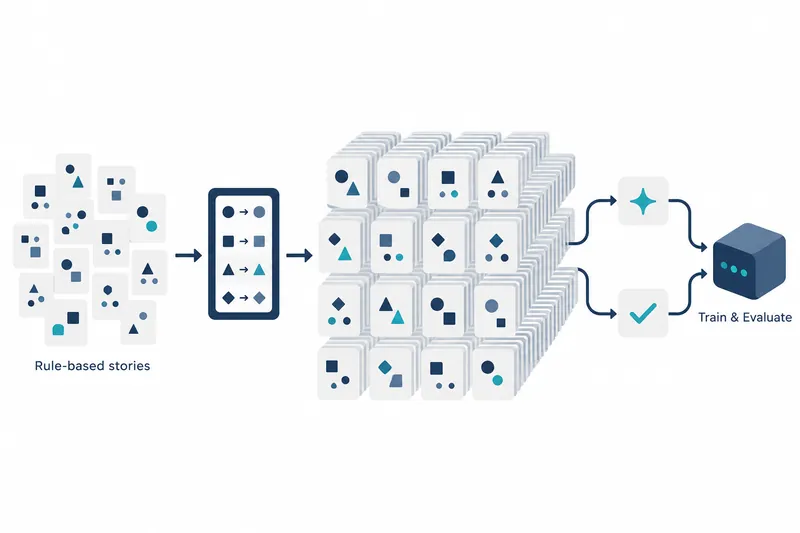
규칙으로 만든 영어 어린이 이야기 5천만 편을 담은 데이터셋 NanoStories가 공개됐다. 소형 언어 모델을 학습하거나 데이터 처리 과정을 큰 규모로 시험하려는 개발자는 신경망 생성에 의존하지 않는 자료를 내려받아 활용할 수 있다.
1. 장면과 단어 목록을 조합한 이야기
각 행에는 완성된 이야기 한 편이 들어가며, 이야기 전체는 열 단위로 저장하는 파일 형식인 Parquet 파일 50개에 나뉘어 있다. 각 파일에는 100만 편이 담긴다. 행의 필드는 영어 이야기 본문을 담은 text 하나여서, 텍스트 전체를 입력으로 쓰는 학습 실험에 연결할 수 있다.
이야기는 물건 찾기나 간식 나누기 등 다섯 가지 줄거리의 장면을 순서대로 이어 만드는 방식이다. 이름·성격·동물 등을 정해진 목록에서 고르며, 약 세 편 중 한 편에는 배경 묘사를 더한다. 다음 표는 데이터셋 소개 문서에 나온 생성기 목록의 크기다.
표: 생성기가 사용하는 주요 목록
조건: 데이터셋 카드에 적힌 규칙 생성기 목록 기준
단위: 개
| 항목 | 개수 |
|---|---|
| 이야기 주제 | 5 |
| 이름 | 20 |
| 성격 | 12 |
| 역할 | 12 |
| 동물 형용사 | 12 |
| 동물 종 | 10 |
2. 학습부터 데이터 처리 시험까지 활용
소개 문서는 소형 언어 모델을 처음부터 학습하거나 다른 합성 어린이 이야기 말뭉치와 비교하는 용도를 제시한다. 문장을 토큰으로 나누는 도구나 데이터를 읽고 학습에 넘기는 처리 과정도 큰 규모로 시험할 수 있다.
개발자는 공개된 데이터셋을 불러와 이런 실험의 입력 자료로 사용할 수 있다. 배포 페이지가 제공하는 불러오기 예시는 다음과 같다.
from datasets import load_dataset

ds = load_dataset("AuroraAI-Research/NanoStories")
파일은 디스크에서 약 4.19GB를 차지한다. 뷰어가 표시한 메모리상 데이터 크기는 약 28.6GB로, 저장 파일 크기보다 크다. 데이터를 읽는 방식을 정할 때는 내려받는 파일의 크기와 메모리상 크기를 함께 고려할 필요가 있다.
3. 휴대전화 CPU로 생성한 5천만 편
소개 문서에 따르면 휴대전화 CPU의 단일 작업자 설정에서 5천만 편을 약 9.5분 만에 생성했다. 신경망 모델 대신 규칙을 이용해 대규모 자료를 만든 사례로 제시한 수치다.
무작위 선택의 시작값인 시드와 한 번에 생성하는 묶음 크기가 같으면, 실행을 반복하거나 작업자 수를 바꿔도 같은 결과가 나온다고 문서는 설명한다. 이런 재현성은 같은 생성 조건의 자료를 바탕으로 실험을 반복할 때 유용하다.
4. 생성 부담 대신 다양성이 실험의 변수
규칙 생성은 신경망 모델을 실행하지 않고 큰 말뭉치, 여러 텍스트를 모아 둔 자료를 만드는 이점을 주는 대신, 다섯 줄거리와 고정 단어 목록의 반복을 대가로 치른다. 소개 문서는 문법 검사·사람의 검토가 없었다고 밝히고, 일반적인 언어 능력이나 실제 글의 품질 측정과 이야기의 교훈을 사실·교육적 권위로 삼는 용도를 적용 범위에서 제외한다.
따라서 이 자료의 활용 초점은 학습·데이터 처리 실험과 생성 규칙의 영향에 놓인다. 소개 문서가 제안한 것처럼 데이터 다양성과 어휘가 소형 모델 학습에 미치는 영향을 살피는 연구에 사용할 수 있다.
5. 공개 파일과 라이선스 확인
데이터셋의 라이선스는 Apache-2.0이다. 저장소 커밋 기록에는 2026년 10월 23일 데이터 업로드와 소개 문서 생성·수정이 기록돼 있다. 개발자는 데이터셋 페이지에서 구성과 사용 예시를 확인하고, 커밋 기록에서 공개 파일과 문서의 변경 내역을 살필 수 있다.
NanoStories의 가치는 규칙으로 만든 대규모 이야기 자료를 소형 모델 학습과 데이터 처리 실험의 공통 출발점으로 제공한다는 데 있다.