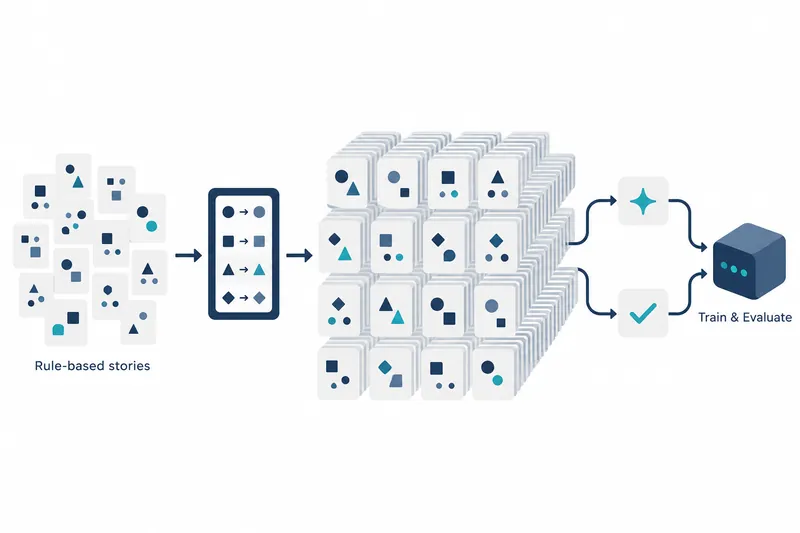
ルールで作った英語の子ども向け物語5千万編を収録したデータセットNanoStoriesが公開された。小型言語モデルの学習やデータ処理の大規模なテストを行いたい開発者は、ニューラルネットワークによる生成に依存しないデータをダウンロードして活用できる。
1. 場面と単語リストを組み合わせた物語
各行には完成した物語が1編入り、物語全体は列単位で保存するファイル形式であるParquetファイル50個に分かれている。各ファイルには100万編が収録される。行のフィールドは英語の物語本文を格納するtextだけなので、テキスト全体を入力に使う学習実験に組み込める。
物語は、物探しやおやつの分け合いなど、五つの筋書きの場面を順番につなげて作る。名前・性格・動物などを決められたリストから選び、約三編に一編には背景描写を加える。次の表は、データセットの紹介文書に記載された生成器のリストの規模を示す。
表:生成器が使う主なリスト
条件:データセットカードに記載されたルール生成器のリストに基づく
単位:個
| 項目 | 個数 |
|---|---|
| 物語のテーマ | 5 |
| 名前 | 20 |
| 性格 | 12 |
| 役割 | 12 |
| 動物の形容詞 | 12 |
| 動物の種 | 10 |
2. 学習からデータ処理のテストまで活用
紹介文書は、小型言語モデルをゼロから学習させたり、ほかの合成された子ども向け物語コーパスと比較したりする用途を挙げている。文をトークンに分割するツールや、データを読み込んで学習に渡す処理も、大規模にテストできる。
開発者は公開データセットを読み込み、こうした実験の入力データに使える。配布ページが示す読み込み例は次のとおりだ。
from datasets import load_dataset

ds = load_dataset("AuroraAI-Research/NanoStories")
ファイルはディスク上で約4.19GBを占める。ビューアーが表示したメモリ上のデータサイズは約28.6GBで、保存ファイルのサイズより大きい。データの読み込み方法を決める際は、ダウンロードするファイルとメモリ上の両方のサイズを考慮する必要がある。
3. 携帯電話のCPUで生成した5千万編
紹介文書によると、携帯電話のCPUでワーカーを一つに設定し、5千万編を約9.5分で生成した。ニューラルネットワークモデルの代わりにルールを使い、大規模なデータを作った事例として示された数値だ。
ランダムな選択の初期値であるシードと、一度に生成するバッチのサイズが同じなら、実行を繰り返したりワーカー数を変えたりしても同じ結果になると文書は説明する。この再現性は、同じ生成条件のデータで実験を繰り返す際に役立つ。
4. 生成の負担に代わり多様性が実験の変数に
ルールによる生成は、ニューラルネットワークモデルを動かさずに大規模なコーパス、つまり複数のテキストを集めた資料を作れる一方、五つの筋書きと固定単語リストの繰り返しを伴う。紹介文書は文法チェックや人による確認を行っていないと明記し、一般的な言語能力や実際の文章の質の測定、物語の教訓を事実や教育上の権威として扱う用途を適用範囲から除外している。
したがって、このデータの活用では、学習・データ処理の実験と生成ルールの影響に焦点が置かれる。紹介文書が提案するように、データの多様性や語彙が小型モデルの学習に及ぼす影響を調べる研究に使える。
5. 公開ファイルとライセンスの確認
データセットのライセンスはApache-2.0だ。リポジトリのコミット履歴には、2026年10月23日のデータアップロードと紹介文書の作成・修正が記録されている。開発者はデータセットページで構成と使用例を確認し、コミット履歴で公開ファイルや文書の変更内容を調べられる。
NanoStoriesの価値は、ルールで作った大規模な物語データを、小型モデルの学習とデータ処理の実験に共通する出発点として提供することにある。