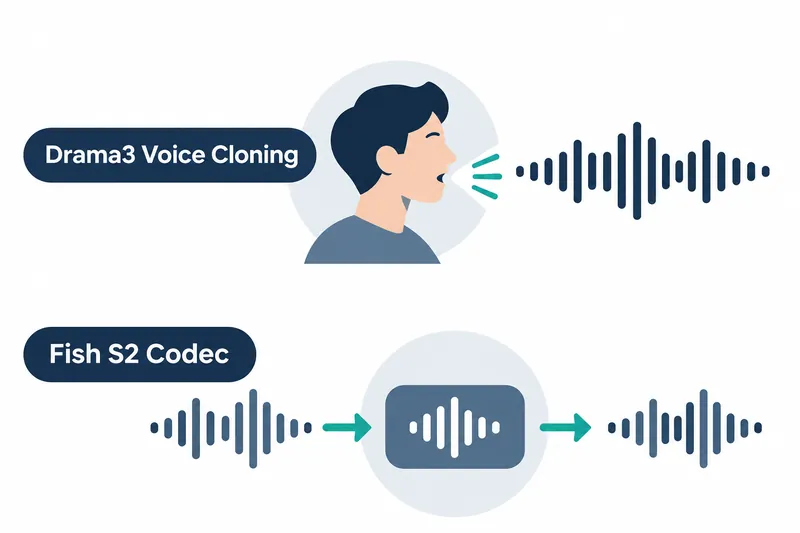
llama.cpp가 음성 합성 모델 Drama 3에서 참고 음성을 이용한 목소리 복제를 지원한다. 음성 합성을 구현하는 개발자는 참고 클립과 그 내용을 적은 전사문으로 목소리를 지정할 수 있으며, 기존 음성 처리용 보조 모델 파일을 다시 변환해 기능을 쓸 수 있다.
1. 참고 클립을 바탕으로 목소리를 지정한다
b12590은 2026년 11월 20일 프리릴리스, 정식 공개 전 시험판으로 공개됐다. 이전 Drama 3 구현은 음성 복제용 참고 파일을 경고와 함께 무시했지만, 이번 변경은 클립의 소리 정보를 생성 입력에 넣어 참고 목소리의 특성을 반영하게 한다.
전사문에는 참고 클립에서 말한 내용을 적는다. 전사문에 화자 표기가 없으면 0번 화자로 처리하며, 생성할 문장에 화자 표기가 없을 때는 참고 전사문의 화자 표기를 이어 쓴다.
2. 출력용 코덱에 입력 경로를 더한다
연결의 핵심은 음성을 내보내는 데 쓰던 코덱을 입력 쪽으로도 활용하는 것이다. Drama 3의 멀티모달, 여러 종류의 정보를 함께 다루는 파일은 음성 생성부와 코덱을 담는 보조 모델 파일이다. 기존에는 소리를 출력하는 디코더만 담았지만, 이제는 참고 음성을 모델이 읽을 코드로 바꾸는 인코더도 포함한다.
인코더 변환 코드는 Fish S2와 공유한다. PR 작성자에 따르면 Fish S2 변환 결과는 기존과 같으며, 여러 축으로 배열된 수치 자료인 텐서 511개와 파일의 구조와 속성을 설명하는 메타데이터 20개 항목을 유지한다. Drama 3에 입력 경로를 더하면서 기존 Fish S2 변환 결과는 유지한 셈이다.
3. 명령줄에서 사용하는 방법
다음은 PR 작성자가 제시한 실행 예시다. 모델과 멀티모달 파일, 참고 음성과 전사문, 새로 읽을 문장을 함께 지정한다.
llama-tts -m drama3.gguf -mm mmproj-drama3.gguf \
--tts-speaker-file reference.wav \
--tts-speaker-text "<|speaker:0|> transcript of the clip" \
-p "text to speak" -o out.wav
참고 음성은 요청당 하나이며 앞부분 최대 30초까지만 사용한다. 인코더가 없는 기존 보조 파일을 쓰면 경고와 함께 참고 음성을 무시하므로, 음성 복제를 쓰기 전 멀티모달 파일을 다시 변환해야 한다.
4. 제출자가 공개한 시험 결과
PR 작성자가 밝힌 시험 대상은 Drama 3 체크포인트, 학습 상태를 저장한 모델 파일 78e5ab79이다. 중심 생성 모델은 가중치당 2비트에 전문가 192개를 사용했고, 멀티모달 파일에는 Q8_0 양자화, 수치 정밀도를 낮춰 저장하는 기법을 적용했다.
작성자는 CUDA 환경에서 시험했으며, 기준 클립과 비교한 WavLM 화자 유사도가 참고 음성이 있을 때 0.883, 없을 때 0.563이었다고 밝혔다. 같은 기준 클립을 놓고 참고 음성을 넣은 쪽이 더 높은 유사도를 보인 결과다.
별도로 떼어 둔 검증용 자료의 단일 참고 음성 프롬프트, 곧 모델에 입력하는 지시문 91개에서는 작성자의 화자 확인 시험을 통과한 항목이 88개였고, 평균 유사도는 0.956이었다.
내용은 음성 인식으로 확인했다. 작성자는 138개 프롬프트 중 136개가 범주별 단어 오류율, 인식 결과의 단어 오류 비율 기준을 충족했다고 밝혔다. 목소리의 유사도와 함께 발화 내용도 점검한 것이다.
5. 모델 추가 대신 파일과 입력 처리가 늘어난다
참고 음성을 지원하는 대신 멀티모달 파일에 코덱 인코더가 추가되고, 입력된 음성 프레임, 짧은 시간 단위로 나눈 음성 데이터마다 프롬프트 행이 들어간다. 따라서 새 기능을 위해 파일을 다시 만들고, 모델이 처리할 입력도 늘어난다. 반면 생성 모델을 별도로 추가하지 않고 한 개의 참조 음성으로 화자 특성을 지정할 수 있다.
이번 릴리스의 실질적 변화는 Fish S2 코덱을 재사용해, 보조 파일 재변환을 거쳐 기존 Drama 3 생성 흐름에 참고 목소리를 넣을 수 있게 한 데 있다.