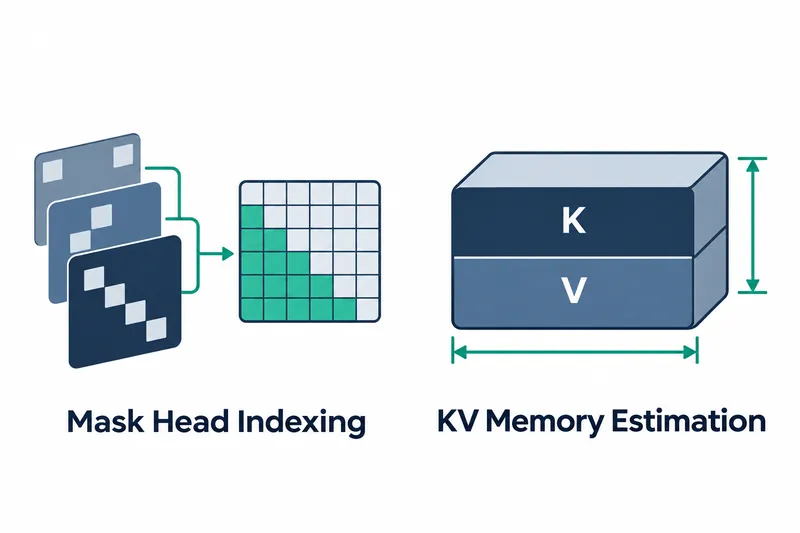
llama.cpp의 새 프리릴리스인 정식 출시 전에 미리 배포하는 시험판은 WebGPU로 모델을 실행할 때 계산에서 참고할 항목을 가리는 어텐션 마스크를 잘못 읽던 문제와 여러 작업이 함께 사용하는 저장 공간인 공유 메모리 사용량을 작게 잡던 문제를 고쳤다. 해당 실행 방식을 쓰는 개발자에게는 잘못된 계산 결과와 메모리 한도 초과의 원인을 함께 바로잡은 업데이트다.
1. 각 헤드에 맞는 마스크 조각을 읽는다
Inkling 2는 어텐션을 나눠 계산하는 단위인 헤드마다 마스크 조각을 하나씩 둔다. 기존 GPU에서 실행되는 셰이더는 마스크를 읽을 위치에 헤드 번호를 반영하지 않아, 헤드별 마스크가 있는 연산에서 잘못된 결과를 냈다. 이 사례를 추가한 연산 테스트도 WebGPU에서 실패했다.
PR #32394는 마스크 위치를 계산할 때 헤드 번호를 포함하도록 바꿨다. 마스크 조각이 여러 헤드에 반복 적용되는 경우에는 헤드 번호를 조각 수로 나눈 나머지를 사용한다. 이는 CPU와 다른 백엔드에서도 쓰는, 작은 배열 값을 반복해 맞추는 브로드캐스트 방식과 같은 규칙이다.
벡터 경로에서는 마스크 헤드별 중간 상태도 따로 다룬다. 이 변경으로 헤드별 마스크 연산을 지원 불가로 거부하는 대신 계산할 수 있게 됐다. 관련 셰이더 코드의 배치와 마스크 헤드 인덱싱은 다음과 같다.
    // Dispatch mapping:
    //  - x indexes KV blocks
    //  - y flattens (batch_idx, mask_head, q_blk) as y = (batch_idx * mask_ne2 + mask_head) * nblk1 + q_blk
    let kv_blk = wg_id.x;
    let y = wg_id.y;
    let q_blk = y % params.nblk1;
    let mask_head = (y / params.nblk1) % params.mask_ne2;
    let batch_idx = y / (params.nblk1 * params.mask_ne2);
2. 키와 값의 메모리 계산을 실제 사용량에 맞춘다
WebGPU의 Flash Attention 구현은 키와 값을 GPU 작업 묶음인 워크그룹이 함께 쓰는 빠른 메모리에 올리거나 직접 읽는다. 수정 전 추정에서는 키 또는 값 가운데 하나만 직접 읽어도 둘의 공유 메모리를 뺐지만, 셰이더는 키와 값을 모두 직접 읽을 때만 그 공간을 제외했다.
이 차이로 키가 f16이고 값이 q8_0인 조합에서는 실제 사용량을 작게 잡아 워크그룹 저장 공간 한계를 넘었다. 수정 후에는 키와 값이 모두 직접 읽힐 때만 추정에서 해당 공간을 빼도록 했다. 서로 다른 저장 형식을 함께 쓰는 경우에도 실제로 필요한 공유 공간을 계산에 남기는 변경이다.
3. 실행 가능한 경로를 지원 판정에 반영한다
연산의 메모리 할당 크기 계산과 지원 여부 판정도 실제 실행 경로와 같은 메모리 규칙을 쓰도록 바꿨다. 행렬 연산 경로가 저장 공간에 맞지 않을 때 다른 계산 경로로 전환하는 동작도 지원 판정에 반영했다. 한 경로의 메모리 부족만으로 연산을 지원 불가로 판단하던 범위를 줄이는 셈이다.
헤드별 마스크를 올바르게 처리하는 대신 보조 메모리는 늘어난다. WebGPU 파라미터 버퍼는 마스크 정보를 담을 필드가 추가되면서 128바이트에서 256바이트로 커졌다. 벡터 경로의 마스크 중간 상태 공간도 마스크 헤드 수를 반영해 할당된다. 이번 변경의 이익은 결과와 지원 판정의 정확도에 있고, 비용은 추가 정보를 저장할 공간에 있다.
4. 작성자는 WebGPU 연산 테스트 3996건 통과를 보고했다
PR 작성자는 CI, 자동 빌드와 테스트를 수행하는 환경, 의 Dawn을 사용하는 NVIDIA WebGPU 환경에서 test-backend-ops -o FLASH_ATTN_EXT를 실행해 3996건이 모두 통과했다고 밝혔다. 이 결과에는 앞서 문제가 됐던 헤드별 마스크 사례 48건이 포함됐다. 이는 모든 연산이 아니라 Flash Attention 대상 3996건에 헤드별 마스크 48건이 포함된 결과이며, 별도의 ctest -L main 통과 보고와는 구별된다.
작성자는 GGML_SCHED_NO_REALLOC 환경 변수를 설정한 추가 테스트도 통과했다고 보고했다. Apple 러너는 GPU 내부의 소규모 작업 묶음으로 행렬을 계산하는 서브그룹 행렬 경로를 시험한다.
PR은 2026년 11월 16일에 병합됐으며, b12441 프리릴리스도 같은 날 공개됐다. 릴리스 페이지에서 여러 운영체제용 바이너리를 받을 수 있다. WebGPU를 쓰면서 헤드별 마스크나 키·값 저장 형식의 조합 때문에 문제가 생겼던 개발자에게 이번 빌드가 직접적인 검토 대상이다.
이번 빌드의 핵심은 WebGPU의 계산 결과와 메모리 지원 판정을 바로잡는 데 있으며, 헤드별 마스크 처리에 필요한 보조 저장 공간은 늘어난다.