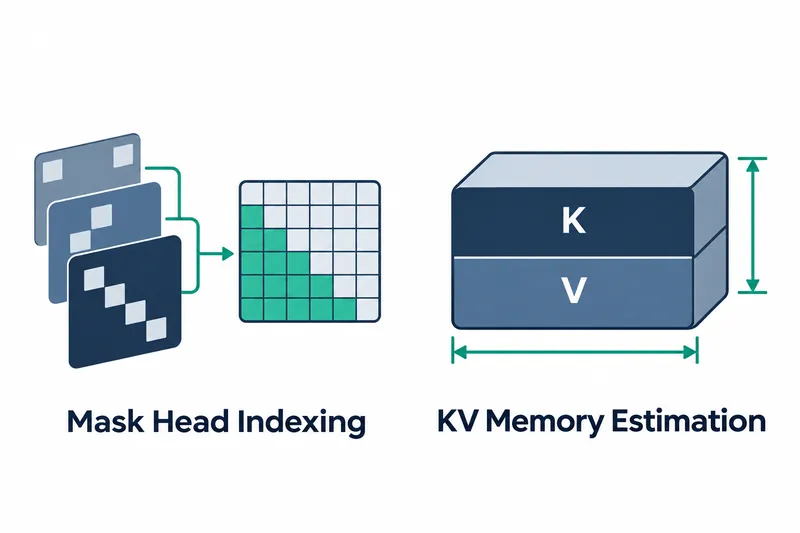
llama.cppの新しいプレリリースは、正式公開前に配布する試験版だ。WebGPUでモデルを実行する際、計算で参照する項目を隠すアテンションマスクを誤って読む問題と、複数の作業で共用する共有メモリの使用量を過小評価する問題を修正した。この実行方式を使う開発者にとって、誤った計算結果とメモリ上限超過の原因をともに是正する更新だ。
1. 各ヘッドに対応するマスクのスライスを読む
Inkling 2は、アテンションを分割して計算する単位であるヘッドごとに、マスクのスライスを1つ持つ。従来のGPU上で動くシェーダーは、マスクの読み取り位置にヘッド番号を反映せず、ヘッド別マスクを持つ演算で誤った結果を出していた。このケースを追加した演算テストもWebGPUで失敗した。
PR #32394は、マスク位置の計算にヘッド番号を含めるよう変更した。マスクのスライスを複数のヘッドに繰り返し適用する場合は、ヘッド番号をスライス数で割った余りを使う。これはCPUや他のバックエンドでも使う、小さな配列の値を繰り返して合わせるブロードキャスト方式と同じ規則だ。
ベクトル経路では、マスクヘッドごとの中間状態も個別に扱う。この変更により、ヘッド別マスクの演算を非対応として拒否せず、計算できるようになった。関連するシェーダーコードの配置とマスクヘッドのインデックス処理は次のとおりだ。
    // Dispatch mapping:
    //  - x indexes KV blocks
    //  - y flattens (batch_idx, mask_head, q_blk) as y = (batch_idx * mask_ne2 + mask_head) * nblk1 + q_blk
    let kv_blk = wg_id.x;
    let y = wg_id.y;
    let q_blk = y % params.nblk1;
    let mask_head = (y / params.nblk1) % params.mask_ne2;
    let batch_idx = y / (params.nblk1 * params.mask_ne2);
2. キーと値のメモリ計算を実使用量に合わせる
WebGPUのFlash Attention実装は、キーと値をGPUの作業単位であるワークグループが共有する高速メモリに載せるか、直接読み取る。修正前の見積もりでは、キーか値の一方だけを直接読む場合も両方の共有メモリを差し引いていたが、シェーダーは両方を直接読む場合にのみ、その領域を除外していた。
この差により、キーがf16、値がq8_0の組み合わせでは、実使用量を過小評価し、ワークグループの記憶領域の上限を超えていた。修正後は、キーと値をともに直接読む場合にのみ、見積もりからその領域を差し引く。異なる保存形式を組み合わせる場合も、実際に必要な共有領域を計算に残す変更だ。
3. 実行可能な経路を対応可否判定に反映する
演算のメモリ割り当てサイズの計算と対応可否判定も、実際の実行経路と同じメモリ規則を使うよう変更した。行列演算経路が記憶領域に収まらない場合に別の計算経路へ切り替える動作も、対応可否判定に反映した。1つの経路のメモリ不足だけで演算を非対応と判断する範囲が狭まる。
ヘッド別マスクを正しく処理する代わりに、補助メモリは増える。WebGPUのパラメータバッファは、マスク情報を格納するフィールドの追加で128バイトから256バイトに拡大した。ベクトル経路のマスク中間状態の領域も、マスクヘッド数を反映して割り当てられる。今回の変更の利点は結果と対応可否判定の正確性にあり、代償は追加情報の保存領域だ。
4. 作成者はWebGPU演算テスト3996件の成功を報告した
PR作成者は、自動ビルドとテストを行うCIのDawnを使うNVIDIA WebGPU環境で、test-backend-ops -o FLASH_ATTN_EXTを実行し、3996件すべてが成功したと述べた。これには問題となっていたヘッド別マスク48件が含まれる。全演算ではなく、Flash Attention対象3996件にヘッド別マスク48件を含む結果であり、別途報告されたctest -L mainの成功とは異なる。
作成者は、GGML_SCHED_NO_REALLOC環境変数を設定した追加テストも成功したと報告した。Appleランナーは、GPU内部の小規模な作業単位で行列を計算するサブグループ行列経路をテストする。
PRは2026年11月16日にマージされ、b12441プレリリースも同日に公開された。リリースページから複数のOS向けバイナリを入手できる。WebGPUでヘッド別マスクやキー・値の保存形式の組み合わせによる問題を抱えていた開発者にとって、今回のビルドは直接的な検討対象だ。
今回のビルドの要点は、WebGPUの計算結果とメモリの対応可否判定を是正することにあり、ヘッド別マスクの処理に必要な補助記憶領域は増える。