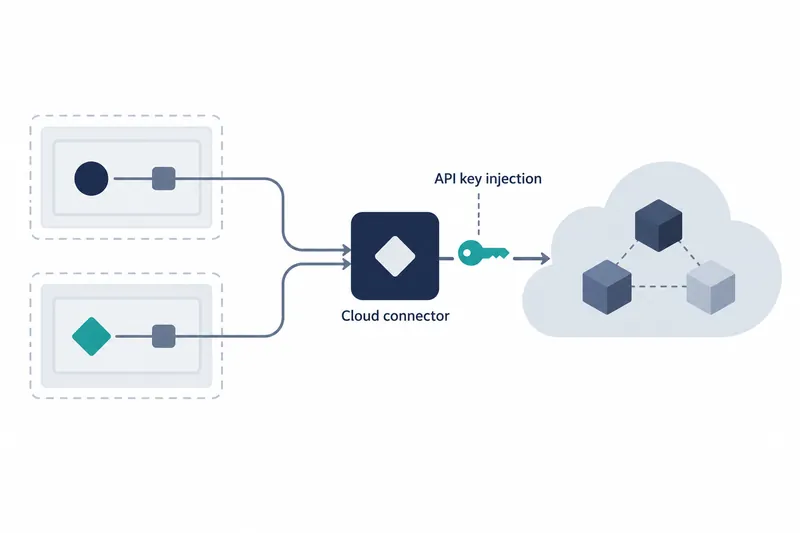
Fly.ioの隔離された仮想コンピューターで動くエージェントが、Ollamaのクラウドモデルを使うための接続機能が追加された。開発者はモデルへのアクセス権を与えつつ、エージェントの実行環境内に秘密キーを置かない構成を利用できる。
1. 実行環境とモデルをつなぐコネクター
Ollamaは2026年10月13日にSprites向けコネクターを公開した。Spriteはセッション終了後もディスクが保持されるLinux仮想マシンだ。エージェントがコマンドを実行する隔離された作業室であり、新コネクターはそこから外部のクラウドモデルを呼び出す経路となる。
発表で対応例として挙げられたモデルにはkimi-k3とglm-5.3がある。ローカルにモデルをインストールするのではなく、仮想マシン内のコードがゲートウェイという中継点を通じてクラウドにリクエストを送る仕組みだ。Ollamaのドキュメントも、クラウドモデルはローカルGPUなしで利用できると説明している。
2. 秘密キーの代わりに中継先アドレスを渡す
ユーザーがOllama APIキーをFly.ioの組織に登録すると、プラットフォームは暗号化して保存し、API経由で返すことはない。ゲートウェイは呼び出し元のSpriteを確認してからリクエストにキーを付与する。実行環境にはゲートウェイのアドレスと接続IDだけが残る。
要点は、エージェントに鍵を渡さず、許可された作業室から中継窓口を利用させることだ。新コネクターはデフォルトではどのSpriteにもアクセスを許可しない。ユーザーがラベルや名前の接頭辞で対象を選ぶか、すべてを許可する。呼び出しはSprite内部でのみ動作する。
この方式は、実行環境にそのキーを置かず、エージェント経由のキー流出経路を減らす一方、キーの保管とリクエスト認証をFly.ioに委ねる選択だ。キーを隠すことはモデルの利用権限までなくすことではないため、全許可は組織内のすべてのSpriteにその接続を開放する判断と捉える必要がある。
3. 接続を登録して内部から呼び出す
必要なのはOllama APIキーと1つ以上のSpriteだ。Fly.ioダッシュボードのSpritesメニューでConnectorsを開き、キーとともにコネクターを追加する。続いてアクセス設定で利用対象を選んで保存し、対象の横にある到達性テストで接続を確認する。
コネクターページには接続IDを埋め込んだコマンドが表示される。以下は発表に掲載された例そのもので、Sprite内で実行する。認証ヘッダーがないのは、ゲートウェイが代わりにキーを付与するためだ。
curl "https://api.sprites.dev/v1/gateway/ollama/<connection_id>/v1/chat/completions" \
  -H "Content-Type: application/json" \
  -d '{"model": "kimi-k3", "messages": [{"role": "user", "content": "Hello!"}]}'
既存のOpenAI SDKを使うコードも接続できる。呼び出し先をゲートウェイに変更すればよく、Ollama独自のAPIパスもこの中継に対応する。
具体的にはbase_urlにゲートウェイのアドレスを指定し、api_keyには任意の値を入れる。この値は実際の秘密キーではなく、認証は先に登録したキーを使ってゲートウェイで処理される。
標準で提供されるコーディングエージェント向けスキルは、エージェントにOllamaの使い方を教える。発表によると、アクセス権のあるSpriteでは、このスキルを通じて追加設定なしでモデルを利用できる。ただし、コネクターの登録とアクセス許可の手順を省略できるという意味ではない。
4. リソース費用と運用責任は残る
Spritesの料金は、実際に使用したCPU時間、メモリ、ストレージに基づいて計算される。実行を停止した状態でコンピューティング料金が発生しなくても、ストレージ費用は残る場合がある。そのため、仮想マシンがアイドル状態というだけで費用全体がなくなると解釈してはならない。
Ollamaの発表は料金ページを案内しているが、クラウドモデルの具体的な料金は示していない。コネクターの利点はモデル呼び出しの速度や価格ではなく、秘密キーの配置場所とアクセス制御方式の変化にある。
このコネクターは、エージェントのモデルへのアクセスを維持しながら秘密キーの管理を実行環境の外へ移しつつ、許可対象とリソース費用はユーザーが管理する接続方式だ。