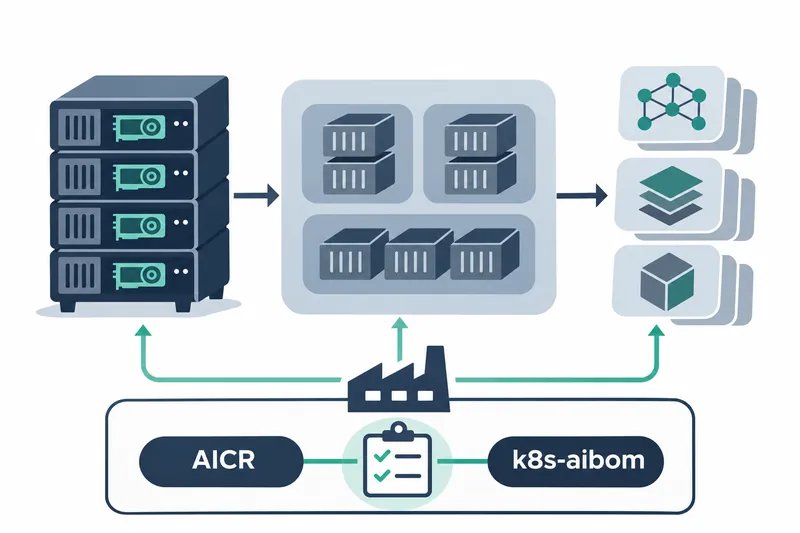
NVIDIAがKubernetes向けGPUプラットフォーム構成ツールにAIワークロードの一覧収集ツールを統合した。プラットフォーム運用チームは、再現可能なインフラのデプロイと実際に検知されたモデル・実行環境の情報を、同じデプロイフローで管理できる。
1. 構成管理と実行一覧を接続
NVIDIA AI Cluster Runtime(AICR)はDSX AIファクトリープラットフォームのオープンソースモジュールだ。クラウド、アクセラレーター、OSと用途を指定すると、バージョンが固定されたデプロイ仕様であるレシピと、インストールに必要なファイルを生成する。この仕様を実際のクラスターの状態と照合して検証できる。
今回の統合で、Googleが開発したオープンソースのk8s-aibomがAICRの検証済み構成要素に加わった。AICRはソースコードとインストールパッケージ、コントローラー、クラスターの作業を自動化する構成要素のイメージなどを特定のバージョンと内容に固定し、1つの試験対象にまとめる。ビルドの出所と権限設定を確認し、インストールからアップグレード、削除まで試験する。
両ツールが調べる対象は異なる。AICRはGPUインフラが既知の構成でデプロイされたかを確認し、k8s-aibomはクラスターで認識したAIワークロードの資産情報を収集する。インフラのデプロイ意図と、その上で検出されたワークロード情報を並べて確認できる構成だ。同じイメージタグでも、ノードやイメージをダウンロードする時点によって異なるコードを指す場合がある。そのため、固定されたインフラレシピだけではワークロードの変更を追跡できない。
2. 検知されたAI資産と根拠を記録
k8s-aibomはKubernetesワークロードと実行単位であるPodの情報を観測する。認識されたAIワークロードごとに、ソフトウェア構成情報を交換するCycloneDX 1.6形式でAI資産一覧を作成する。
推論サービスだけでなく、エージェント、検索拡張生成(検索結果を回答生成に活用する方式)の構成、ベクトルデータベース(意味の類似度で情報を探すストレージ)、学習ジョブと評価ツールもサポート対象に含まれる。
子ワークロードが親ジョブから生成された場合は、親の文書にまとめて重複記録を減らす。
一覧にはモデルやコンテナーイメージ、実行環境など、ワークロードで確認した属性と判断根拠が含まれる。モデルの実行引数に明示した名前は直接宣言された値として、イメージや慣例的な環境変数から読み取った情報は推定値として表示する。
判別できなかった値も別途表示する。署名検証は署名を使って出所と変更を確認する手順だ。運用チームが定めた信頼基準と署名者の条件を満たして検証に合格すると、モデル情報に検証等級を付与できる。NVIDIAのデフォルト構成では、この検証は無効になっている。
3. レシピで選択し、名前空間にマークを付与
ブログで説明されたAICR v1.2.0カタログは、k8s-aibom 1.6.2を固定している。例を再現する際は、このカタログに対応したコマンドラインツールを使用する。
サンプル環境はKubernetes 1.32以上を実行するGoogle Kubernetes Engine(GKE)クラスターだ。H100とContainer-Optimized OS(COS)を使う2つの推論レシピでは、デフォルトで一覧収集ツールが選択され、ほかのGKEレシピでも生成時に選択できる。レシピを作成するコマンドは次のとおり。
aicr recipe \
--service gke \
--accelerator h100 \
--os cos \
--intent inference \
--output recipe.yaml
インストール後は、クラスター内でリソースを分ける区画である名前空間にマークを付ける。マークされた場所で認識された、サポート対象のワークロードの一覧が生成される。
4. 収集負荷と運用上の考慮点
同社の発表によると、元プロジェクトの測定はGKEのNVIDIA DynamoおよびAICR構成で、k8s-aibom v1.6.1を使って行われた。CPU専用ノードでワークロードPodをPending状態のまま残したうえで、15分間の定常状態を観測した。ワークロードPodは実際には実行されていないため、これらの数値はコントローラーの一覧収集負荷を示す。
表:コントローラーの定常状態のリソース使用量
条件:k8s-aibom v1.6.1、GKE、NVIDIA DynamoおよびAICR構成、CPU専用ノード、ワークロードPodはPending(実行されず)のまま、15分間の定常状態観測
単位:APIサーバーへのリクエストは件/分、CPUはミリコア、メモリはMiB
| 項目 | 値 |
|---|---|
| APIサーバーへのリクエスト(約) | 4 |
| コントローラーのCPU平均 | 2.2 |
| コントローラーの実使用メモリ | 28–34 |
数値はAIモデルの処理性能ではなく、一覧収集コントローラーの負荷を示す。別の割り当て基準であるチャートのデフォルトのリソース要求量はCPU 50ミリコア・メモリ128MiBで、観測された負荷はこれより低い。デフォルトの要求量は測定結果ではなく、v1.6.1の試験に適用された設定値と確認されたものでもない。同じ試験でワークロードのイメージタグを変更した際、一覧は一度再生成された。
コントローラーは、一覧生成の対象としてマークされていない場所も含め、クラスター全体のPod設定と設定に直接記載された環境変数の値をメモリに保持する。デフォルト構成では、外部ストレージへの送信とシークレット値へのアクセスは設定されていない。
5. デプロイ意図と観測結果の接続
一覧に含まれるのは、サポート対象の種類で、認識可能なAIの手掛かりを持つワークロードだけであり、Podがイメージをダウンロードする前でも準備完了と表示される場合がある。したがって、宣言された内容と確認可能な情報の一覧であり、スケジューリングや実行成功を確認する結果ではない。
AICRレシピのデプロイ意図と実行環境で観測した資産一覧を照合するには、共通の資産識別子(資産を区別する固有の印)、情報の鮮度基準、インフラとワークロードの範囲の対応付けが必要だ。NVIDIAはこの接続を今後の統合課題として挙げた。
今回の統合の実益は、再現可能なGPUデプロイにAI資産の根拠を加え、運用チームがインフラとワークロードを併せて検討する出発点を用意したことにある。