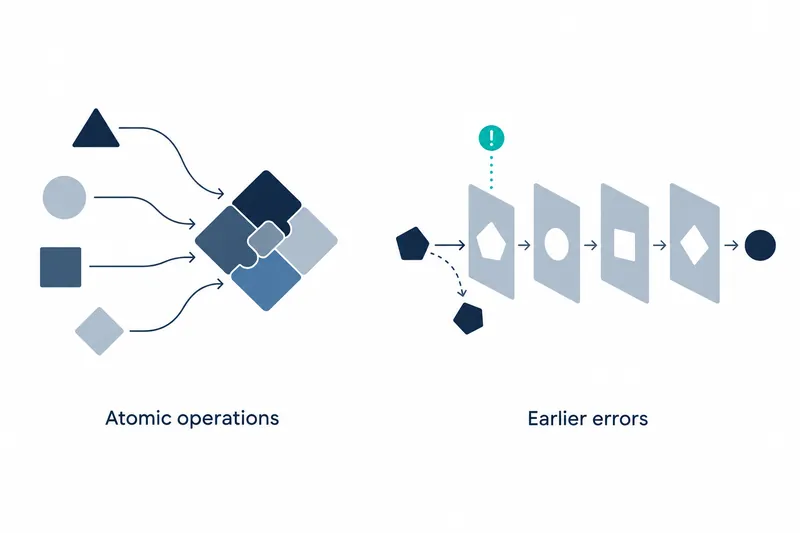
Triton 3.9.0 为 GPU 内核开发者增强了原子操作及编译检查,原子操作是不会被其他操作插入的内存操作。开发者可以直接控制内核的内存行为,部分无效输入会在运行前的编译阶段被发现。用于调试的解释器通过读取代码来模拟其行为,此次修正使其与编译后的内核更一致,也有助于核对结果。
1. 通过原子操作控制内存读写
本版本新增了以不可分割的单次操作读取或写入内存值的原子操作。新引入的 tl.atomic_load 和 tl.atomic_store 也可在 Gluon 和解释器中使用。
tl.atomic_poll 会等待指定地址的值与预期值相等。若在时限内仍不相等,则返回假,因此可为等待数值就绪的操作设置终止条件。
将内存顺序处理扩展到整个块的好处,伴随着额外同步操作的成本;内存顺序是指读写被观察到的顺序。指定了读写顺序的原子操作会加入屏障,即暂停执行流以同步同一执行块内流程的同步点。可指定 sem="relaxed" 来避开这一屏障,因此开发者需要同时考虑所需的顺序保证与同步开销。
2. 在运行前发现无效输入
解包包含多个值的元组时,若接收项数量不匹配,现在会在编译时失败。用于选取最大若干项的 tl.topk 在选择数量无效时,以及用于拼接数组的 tl.cat 在形状不匹配时,也会在同一阶段报错。
向计算频率分布的 tl.histogram 传入非 32 位输入时,也会在运行前报错。这一变化将输入错误的发现提前到编译阶段,让开发者可以先检查输入与调用位置,而不必等内核运行后再从结果中寻找异常。
编译时间也有所改善。根据发行说明,嵌套深度为 8 的深层循环编译速度提高了约 10 倍。这是在该嵌套深度下给出的结果。
3. 使解释器与编译后内核的结果一致
用于调试的解释器通过解释代码来执行,此次修正着重于让其结果与编译后的内核一致。修正涉及整数溢出,即数值超出可表示范围的情况,以及求整数乘积高位的操作,即获取整数表示中较高位的比特。
将乘法与加法合并处理的融合运算及直方图计算也得到修正,使结果一致。开发者在解释器中检查这些运算时,会更少遇到因执行方式不同而产生的结果不一致。配合提前发现错误的编译检查,计算结果的验证环节也得到了改进。
4. 检查现有内核的数据类型转换
若除法或取余运算的操作数,即作为运算输入的值,包含位宽小于 32 位的浮点值,结果就会变为 float32。与 Python 标量一起使用时也适用。若要保留原有数据类型的结果,需要将运算结果转换为所需类型。
张量的数学方法也会采用与函数相同的数据类型检查。例如,指数函数方法在输入为 16 位浮点数时会编译失败。发行说明给出了以下先转换为 32 位浮点数的示例。
x.to(tl.float32).exp()这些变化也使原先自动处理数据类型的代码出现需要修改之处。升级时,除了修复新出现的编译错误,还需要检查运算结果将以何种数据类型存储。
5. 为下一版本的融合默认设置做准备
自动合并乘法与加法的隐式浮点融合在 3.9 中仍保持启用。不过,编译未指定 enable_fp_fusion 的内核时,每个进程会收到一次警告。在 3.10 中,这种融合计划默认关闭。
发行说明建议,数值结果依赖融合的内核应显式调用 tl.fma。这种做法不依赖当前默认设置,而是将计算意图保留在代码中,为下一版本的默认设置变化做准备。
Triton 3.9.0 的核心在于让内核开发者直接处理原子内存行为、更早发现错误,并在下一版本到来前检查已变更的顺序与类型规则。