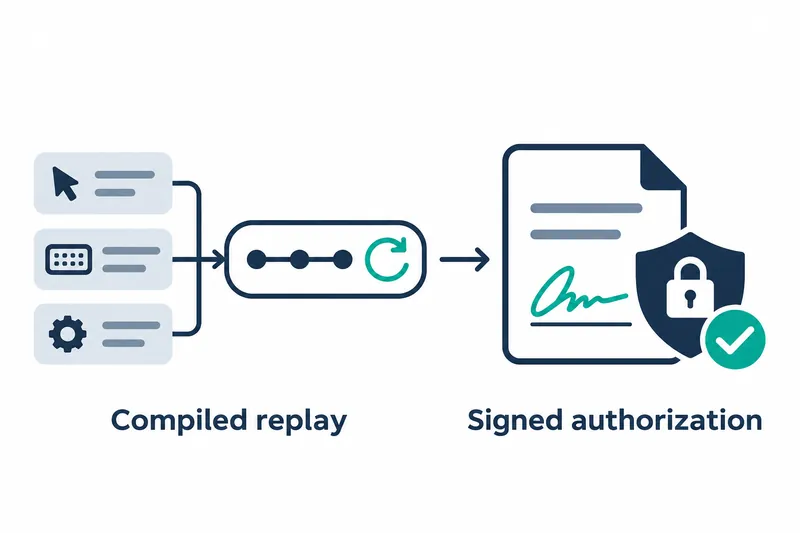
OpenAdapt Flow 2.7.0 引入了将智能体执行过一次的任务转为程序,并用新输入再次执行的功能。在教授浏览器和桌面应用的保存操作时,它采用人工签名授权。开发者在减少重复任务中的模型调用的同时,也需要更严格地检查执行前后的记录和结果。
1. 将执行过一次的任务转为程序重放
新命令 openadapt wrap 用于执行由运维人员预先定义输入项的任务。首次调用时,先运行一次智能体并独立检查保存的记录,再将执行内容转为程序并批准。此后,获批程序会用新输入重放任务,不再调用模型。
任务也可以通过用于工具互联的通信协议 MCP 在本地提供,供其他工具调用。调用方使用任务声明的输入项。附加请求标识符后,重复或中断的调用会返回已有的执行,避免再次发送相同的写入。
模型看到的任务输入和目标身份信息,会被带有类型标记的占位符替代,而非实际值。模型输入占位符后,执行工具填入实际值,重新读取保存结果进行核验的过程也在本地使用实际值完成。原文说明,过去仅遮蔽姓名和标识号码的方式,使模型无法区分目标记录。
发送给模型的请求大小也有所调整。据公司公告,Claude 单次请求在发送前的默认上限从 64 KiB 提高至 4 MiB。公告称,在原有上限下,每轮加入截图的执行会在第二轮结束。OpenAI 的默认上限仍为 64 KiB,可配置的最大值为 32 MiB。
2. 在人工签名授权范围内学习保存操作
在浏览器中教授保存操作时,现在可以使用人工签名的授权文档。文档包含任务与输入、允许的来源、允许的写入以及禁止的操作。首次执行须在授权通过验证且涵盖允许的写入后才会开始,点击、按键和选择操作都会与授权核对。系统还提供创建、签署和验证授权的命令。
在桌面和远程应用中,也可以通过 MCP 教授保存操作,再调用获批工具。授权文档也涵盖桌面和远程界面,而在桌面上教授的操作,其授权范围绑定于相应应用。
3. 不仅检查执行结果,也检查评分器本身
在监控直接写入数据库的客户端模式下,智能体会报告每个操作的开始和结束。Flow 会检查各操作预设的数据库变更条件,以及操作之间的变化。不属于任何操作的变化,会依据应用审计记录是否指向智能体用户,被判定为违规或不确定。
新的审计工具测试的是环境中的评分器,而非智能体。它向基准执行注入错误记录、错误值、重复写入和部分写入等故障,也运行带有无关变化的正常对照案例。除误放错误结果或误拒合法结果的案例外,它还报告表示错误率估计不确定性范围的威尔逊 95% 区间。原文中的执行命令如下。
python -m openadapt_flow.verifier_audit run --target module:factory --out DIR对于分页的 REST(Web 资源请求与响应通信方式)和 FHIR(医疗信息交换标准规范)读取,系统要求承诺读取的是不变的数据集,并声明已收到全部记录。这是在汇集多页结果时,核验数据是否未变以及读取是否无遗漏的标准。
4. 升级时检查执行目标与记录条件
必须明确指定要重放的目标地址或演示应用,并使用长命令行选项的完整名称。
对于记录了区域设置、日期顺序和键盘布局的任务,系统会将其与当前环境对照;缺少这些信息的旧任务则不参与该项检查。
包含数字的身份信息中,日期、年龄和数量也必须与当前界面上的值按原文完全一致。
分页读取中,若缺少完整性声明,或数据集标记缺失或发生变化,或标识符重复,或混用了不同的标识符命名空间(区分标识符的范围),结果将保持未确定状态。若环境信息与记录不同或无法读取,系统会拒绝重放;重放失败或结果不确定时,则会暂停,直到人工批准修复。
5. 减少模型调用,转而投入审批流程
使用获批程序处理重复任务,可以省去模型调用,也能减少重复写入。首次执行使用模型时,会在调用前施加成本和执行时间上限,并在执行后报告用量。
相应地,运维人员在首次教授任务时,需要准备授权文档和独立的记录核验。后续修复也包含人工审批、签名重新授权和小规模试运行流程。重复执行所节省的模型调用,其代价转移为初始设置和修复过程中的核验工作。
Flow 2.7.0 在减少重复任务中模型调用的同时,将证明写入权限和结果的核验流程更深入地融入执行流程。