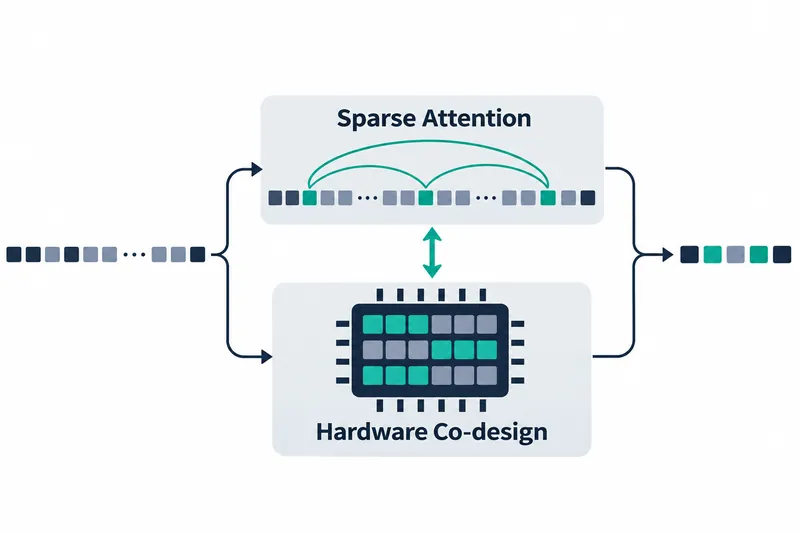
NVIDIA 面向处理长文档和大型代码库的模型开发者发布了稀疏注意力设计指南。这种方法不止于挑选必要的键进行计算,还将键选择与实际读取计算两个阶段共同优化,以降低长上下文的处理负担。其适用对象是在训练过程中引入稀疏性的模型设计。
1. 计算量减少后,键选择成为新瓶颈
常规注意力会为每个查询比较所有键,而稀疏注意力只使用相关性较高的几千个键。这就像不必读完整本书,只翻阅需要的页面。不过,负责寻找所需页面的索引器仍然要对所有键评分。
据该公司公布的数据,在 DeepSeek V3.2 处理 128K 个输入词元时,索引器和排名靠前的键选择占单层执行时间的 47%。寻找键的时间超过实际注意力计算时间,因此优化重点也转向选择阶段。
NVIDIA GPU,DeepSeek V3.2 的 DSA,输入长度为 128K 个词元,以各层输入处理时间为基准
| 项目 | 时间占比 |
|---|---|
| 索引器与排名靠前的键选择 | 47 |
| 核心注意力 | 24 |
| 前馈神经网络运算 | 25 |
下表列出同一模型、同一输入长度下各主要阶段的时间占比。据该公司公布的数据,索引器和排名靠前的键选择占比高于核心注意力的 24%。
2. 输入处理与词元生成的瓶颈不同
索引器通过矩阵乘法比较查询和键,即将行与列相乘后求和,再经后处理为每个键生成一个分数。在一次性处理输入的阶段,大型矩阵乘法的计算量很重要。而在生成下一个词元的阶段,即使查询很少,也要读取整个键缓存,即存储此前计算所得键的内存,因此内存读取是主要瓶颈。
以下索引器测量的默认条件据该公司公布:采用 8 位浮点数(FP8)内核,即在 GPU 上执行计算的程序;索引器键数量为 64K;压缩比,即表示相对原始数据缩减程度的数值,为 4;头维度,即每个头处理的向量大小,为 128。键头数量为一个,输入处理批大小为 1,词元生成批大小为 128。压缩比实验将序列长度固定为 256K。
共享同一个键头的查询头数量称为组大小。据该公司公布的数据,即使组大小增至 16 倍,词元生成阶段的执行时间变化也只有 2%。这是因为键缓存只需读取一次,就能供多个查询头使用。
收益与成本因阶段而异。增大组可以更充分地利用从内存读取的键,但也会增加输入处理阶段的计算量和执行时间。模型开发者不仅要考虑词元生成效率,还要兼顾首次处理长输入的成本。
3. 草稿验证需适配单次处理容量
同时验证多个草稿词元的推测解码也会复用同一键缓存。此时,组大小与待验证查询数量共同占用分块空间,分块是 GPU 成批计算的数据单元。NVIDIA 表示,在 32 位浮点数(FP32)后处理中,实际可在一个分块内放入约 200 个查询行。
据该公司公布的数据,组大小为 32、处理 6 个查询时,工作量为 6 倍,执行时间为 1.37 倍。组大小为 8、处理 26 个查询时,工作量为 26 倍,执行时间为 1.87 倍。各项数值均以对应组大小下处理一个查询为基准;一旦超出分块容量,就需额外读取缓存,执行时间随之跃升。
NVIDIA 建议将索引器头维度设为 128 或 256。据该公司公布的数据,从 64 扩展到 128 时,输入处理时间变为 1.1~1.2 倍,但在词元生成阶段,读取成本随键数据量增加而上升。键头从一个增至 8 个时,输入处理时间变为 1.3~1.6 倍,词元生成时间变为 7.6 倍。
4. 同时减少评分对象与中间数据搬运
将键压缩以代表多个词元、分层缩小候选范围,或在层间共享选择结果,都能减少评分工作。在 NVIDIA 的压缩比实验中,压缩比降至一半时,输入处理时间变为两倍。词元生成时间也大致变为两倍,而在键缓存为 8K 的条件下则为 1.8 倍。
将保留高分键的 Top-k 与索引器内核融合,可以消除将全部分数写入内存后再读取的过程。TensorRT LLM 还提供一种方式,在生成下一个词元时,将上一步的选择结果作为估计值复用。
据该公司公布的数据,在 DeepSeek V3.2 和 DeepSeek V4 的词元生成阶段,这种复用方式的速度是传统按数位筛选分数的选择方式的 2.1~2.4 倍。
开发者可参考 FlashInfer 的公开实现,了解将索引器与选择操作合并到同一内核的方法。
5. 选择连续块,更易共享已读取数据
逐词元选择键会使选中的数据散落在缓存各处。若选择连续块,即由连续数据组成的单元,就能批量读取,并在选择同一块的查询之间共享数据。这也是 NVIDIA 建议优先考虑大块的原因。
据该公司公布的数据,在每个查询固定选择 2,048 个键的实验中,块大小减半时,输入处理和词元生成时间几乎变为两倍。即使计算量和键值数据总量不变,块数量增加也会带来更多查询数据加载与部分结果合并工作。
长上下文推理的优化单元不是单个注意力内核,而是从键选择到数据读取的整条路径。