Microsoft Research Asia 发布了 Agent Lightning v1.0,无需重建部署中的智能体即可接入强化学习。将智能体发往模型的请求接入框架的转发节点后,就能保留现有执行结构开展学习,减轻开发者另行复制训练用智能体的负担。
1. 使用实际运行框架,而非训练用副本
运行框架负责协调智能体的上下文管理和工具执行。在以往的智能体强化学习系统中,训练框架管理与环境的交互过程,因此需要在训练环境内重新实现这套运行框架。
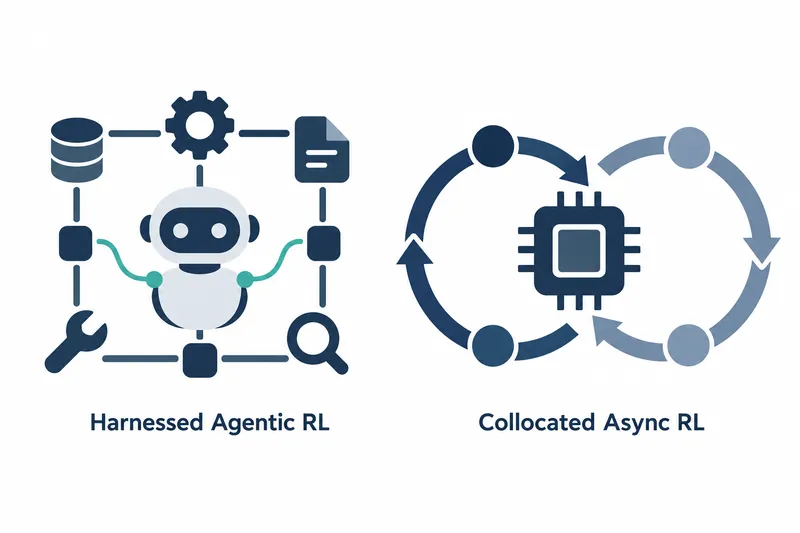
Agent Lightning 在智能体与模型之间设置语言模型代理。开发者将原有的模型调用地址改为代理地址,智能体仍按平常的方式运行。框架记录调用和响应并用于训练。v1.0 将部署用智能体运行框架直接参与强化学习的方法概括为“基于运行框架的智能体强化学习”。
2. 三个组件连接智能体运行与训练
据公司介绍,整个框架,即整合多种功能以辅助开发的基础设施,约有 3,500 行代码,由记录模型调用的 API 网关、运行智能体的控制器,以及将运行结果转换为学习资料的训练器组成。控制器通过本地进程或标准 Kubernetes 任务运行智能体,基于 verl 的训练器接收结果并构建训练样本。
开发者需要接入的位置是现有运行框架的模型调用地址。将其改为网关地址,通常即可接入训练。由于执行与学习相互分离,这一设计减少了将运行框架本身迁入训练框架的工作。
3. 将运行框架拆分的样本作为训练单元处理
当运行框架负责执行流程时,模型请求与响应会依次进入训练系统。一次任务会拆分成多个样本,因此关键是按任务分组处理,避免产生更多样本的任务在学习中占据过高权重。
研究人员按任务应用了“优势计算”和“损失归一化”,前者评估行为相较基准好多少,后者调整学习误差的权重。根据公司发布的信息,在展示 Qwen3.5-9B 于 SWE-smith 验证集上训练 200 步结果的图表中,同时采用两种方法的验证奖励约为 0.37,在对比方法中最高。
仅将优势计算改为按任务处理的方法,其表示响应选择不确定性的策略熵升至约 0.65。公司称,同时采用两种方法时,该值更低且更稳定。
4. 用同一组 GPU 衔接运行与更新
当智能体之间的运行时间差异较大时,同步学习可能因等待最慢的运行任务而使 GPU 闲置。完全异步方式提高了利用率,但为执行与学习分别配置 GPU 资源。Agent Lightning v1.0 的“同置异步强化学习”在一组 GPU 上交替处理智能体运行与模型更新。
收集到足够的运行结果后,系统会暂停新请求,待进行中的请求完成后更新模型。随后恢复运行,因此外部运行框架无需直接管理这一切换。
据公司发布的信息,整体处理速度比同步强化学习快约 2 倍,且比现有异步方式使用更少的 GPU。原文资源配置示意图给出的例子是:同步方式与同置方式各配置 4 个 GPU,异步方式配置 8 个 GPU。
5. 同时看待性能提升与运维负担
该公司利用公开数据集 SWE-smith 和编码智能体 mini-SWE-agent,构建了涵盖数据清洗、环境配置、奖励操纵防御及强化学习的流水线,即串联多个处理阶段的工作流程。
据公司发布的信息,仅用约 6,000 个样本对 Qwen3.5-9B 进行强化学习后,其在 SWE-bench Verified 上首次尝试解决问题的比例从 41.8% 升至 56.4%。原文给出的增幅为 14.6 个百分点。
支持标准 Kubernetes 任务后,团队可以利用自有集群,即将多台计算机组合运行的环境,或云端、本地基础设施,减少对商业沙箱服务,即隔离测试代码的环境服务的依赖。但同时运行多个智能体需要 CPU、内存等计算资源,选择自行运维的团队将承担基础设施管理负担。
Agent Lightning v1.0 连接实际运行框架,而非训练用智能体副本,缩小了学习与部署之间的差距,同时仍将运行基础设施的运维责任留给团队。