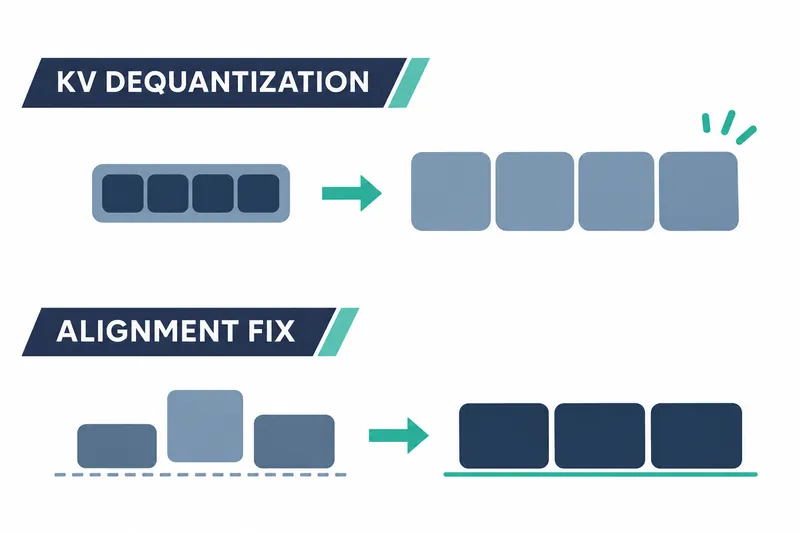
模型运行软件 llama.cpp 的 b12291 扩大了复用既往计算结果的缓存处理优化范围。此次更新扩展了 Vulkan 模型计算路径中的优化范围,并修复了错误分类部分数据大小的问题。开发团队观察到特定大小下的速度大幅提升,并表示,即使未应用新优化,错误修复也有望带来帮助。
1. 扩大缓存数据参与计算的路径范围
本次发布中的变更扩大了 Vulkan 中可使用键值缓存反量化优化的路径范围。键值缓存是存储并复用既往计算结果的空间。反量化是将压缩后的数据还原为可用于计算的形式的处理过程。此次变更的重点是扩大可利用这一处理优化的执行路径范围。
这项优化也允许用于 coopmat2(CM2) 路径,是否应用则依据查询令牌数与 GQA 比例乘积的判断标准。GQA 比例是查询头数与键值头数之比。注意力是计算输入元素之间关系的运算,不仅输入长度,这一运算的头配置也会影响优化选择。
因此,Vulkan 用户需要关注的不只是运行环境的名称,还有实际任务中选择了哪条处理路径。发布说明提出的两个因素,为开发者结合自身输入和模型配置理解变更提供了线索。即使使用相同的 Vulkan 环境,也应同时查看查询令牌数和模型的头配置,这是理解此次变更的起点。
2. 修复将已对齐数据错误分类的问题
开发团队表示,在开发过程中观察到特定头大小下的速度显著提升。头是分担注意力运算的单位。发布说明指出,这些大小此前被错误地视为未对齐,现已修正为按已对齐处理。
对齐判断用于检查数据的内存布局是否遵循适合计算的间隔和位置。由于 GQA 使用 nbq2 值作为数据访问间隔,即步长(stride),对齐检查也已改为检查该值。这项变更并非重新排列数据,而是修正检查对齐状态所用的基准值。
开发团队预计,即使未应用反量化优化,对齐修正也会有所帮助。因此,运行 Vulkan 环境的开发者除了查看是否应用新的缓存处理路径,还可以单独考察对齐判断修正的效果。
3. 应结合性能收益与采用验证作出判断
发布说明未提供吞吐量、提升倍数,以及测量所用的硬件、模型和设置。因此,要将性能改进的收益作为实际采用的依据,还需要安排验证工作,用正在使用的模型和输入确认相较旧版本的效果。
4. 可通过已发布的 Vulkan 构建版本考察变更
b12291 于 2026年11月11日作为预览版发布。评估该版本的用户可在发布页面的分发文件列表中,选择适合其操作系统和处理器配置的 Vulkan 构建版本。
Ubuntu 的分发列表包含适用于 x64 和 arm64 的 Vulkan 构建版本。Windows 列表也提供了这两种架构的 Vulkan 构建版本。在这些环境中,可以从公开的软件包入手考察此次变更。分发列表不仅按操作系统划分,也按处理器架构划分,因此选择文件时应同时确认这两项。
b12291 的核心在于扩大 Vulkan 缓存优化的适用路径,同时修复即使在该优化之外也有意义的对齐判断错误。