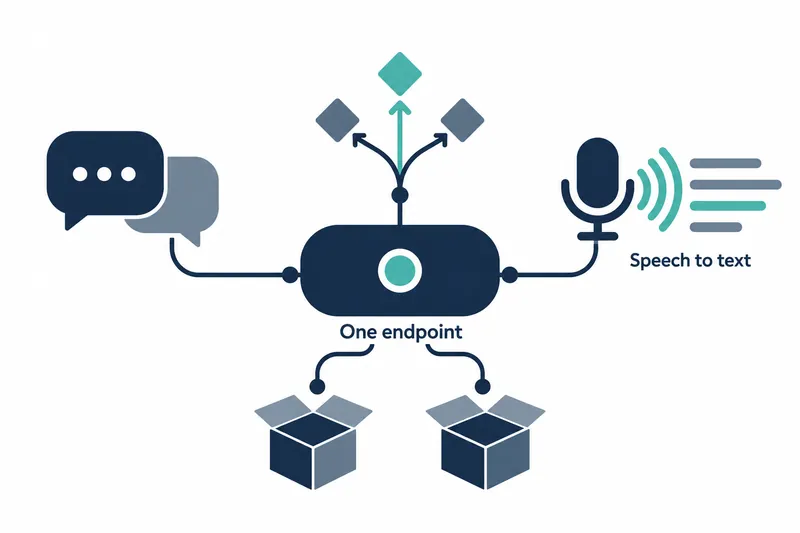
IBM 用一个模型提供对话响应、选项决策和语音转文字功能。希望在对话服务中加入语音或分类功能的开发者,无需另设服务器,即可向同一接入点发送请求。
1. 将所需功能整合到基础模型中
模型卡记载的公开日期为 2026年 10月 14日,介绍博客于次日发布。模型推出了基础模型参数量为 80亿和 300亿的两种配置。权重以 Apache-2.0 许可证开放。
两种配置均包含两个适配器,即用于扩展功能的小型附加权重。通用决策适配器接收状态和选项,返回各选项的概率;安全决策适配器则检测有害性或越狱尝试等。配置中还包含一个参数量为 4亿 7000万的语音识别器。
适配器复用基础模型处理前缀时保存的计算结果,即缓存。
语音先由识别器转成文字,再放入对话上下文,因此不同于语言模型直接理解声音的方式。
2. 共用服务器,响应解读方式却不同
在 vLLM 中,需要安装该项目的插件后运行。下面是 8B 模型卡中的服务器启动示例,适用于下载仓库并进入对应目录后执行。
pip install -e ".[vllm]"

python -m vllm.entrypoints.openai.api_server \
  --model ibm-granite/granite-switch-4.1-8b \
  --port 8000
在请求的 adapter_name 中传入适配器名称后,对话模板会插入用于切换的控制 token。通用决策调用不使用系统指令,而是将状态和问题拆成两条用户消息发送。这种设计旨在让状态部分与普通对话保持一致,以共享前缀计算。
读取决策结果时,不是请求回答语句,而是请求选项标签概率的对数值,即对数概率。指定可用单个 token 表示的标签,并将返回值归一化为所有选项的概率。安全决策适配器则不同,它以 JSON 返回是或否的判断。
3. 决策得分应在评估范围内解读
模型卡采用 v0.3 评分方式,对 Decision Index 公开快速评估子集中的 1,068 个条目进行了评估。
评估在托管的 vLLM 上进行。由于使用了固定的决策系统指令、状态以及带单 token 标签的选项,其指令条件与前述通用调用示例不同。
按 100 分制,决策适配器的整体得分为 8B 的 42.9 和 30B 的 50.1。将各领域得分放大 100 倍后,工具领域分别为 59.8 和 76.5,检索领域则均为 49.8。这意味着大模型的优势并非在所有领域都相同。
在未经训练的领域,通用决策概率应被视为进一步判断的起点,而不是确定的分类结果。
模型卡称,同一配置的本地评估与托管评估结果差异约在 0.6 分以内。不过,卡中未提供测试硬件和量化条件。仅凭这些得分,无法判断部署速度或内存使用量。
4. 服务器整合的收益伴随着调用处理成本
IBM 表示,整合后的模型 GPU 显存使用量与仅使用基础模型时大致相同。按功能拆分服务器的负担有所降低,但应用程序仍须根据响应类型,分别处理概率计算和安全判断解读。
选项越多,请求次数也越多。vLLM 将单次标签对数概率请求限制为 128 个 token。模型卡建议保持问题不变,将标签按每组不超过 128 个拆分请求,再合并结果计算概率。这在数学上等同于不设上限的调用,但需要多次请求。
5. 语音错误和安全验证需单独审视
语音输入仅支持英语,输出为小写且不含标点。语音识别器与语言模型未经过联合训练,两者之间也没有经训练得到的连接。转写错误可能改变后续回答或决策的内容。
内置安全适配器不能替代应用层面的安全测试。公开配置不包含事实性检测、纠正或策略护栏适配器。
Granite Switch 4.1 的采用价值,与其说在于服务器整合本身,不如说取决于整合后能否承担各功能的响应处理与验证工作。