DeepSpeed가 전문가 혼합 모델, 여러 전문가 중 일부를 골라 쓰는 모델의 메모리 처리와 여러 장치로 나눠 수행하는 학습 기능을 보강한 새 버전을 공개했다. 대규모 모델을 학습하는 개발자는 확장된 병렬 처리 기능과 오류 수정을 활용할 수 있으며, 삭제되거나 폐기 예정으로 지정된 구형 기능을 쓰는 코드는 점검할 필요가 있다.
1. 전문가 층마다 두던 임시 저장 공간을 공유한다
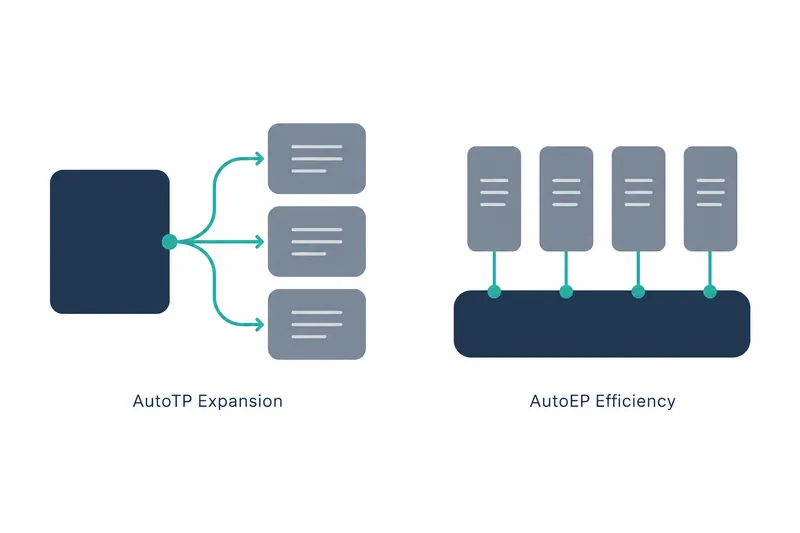
10월 20일 공개된 이번 버전에서 AutoEP는 전문가 혼합 모델의 여러 층이 DeepEP 버퍼 하나를 공유하도록 바뀌었다. 층마다 따로 두던 임시 저장 공간을 함께 쓰는 방식으로 바꾼 것이다.
AutoEP의 기본 결합 처리에서는 중복된 32비트 실수 복사도 없앴다. 분할 계획과 토큰 묶기, 입력 조각을 한데 모으는 작업을 겹쳐 처리하는 변경도 포함됐다. 메모리를 다루는 방식과 작업 순서를 함께 손본 셈이다.
일부 전문가 연산을 묶어 실행하는 융합 처리와 메모리 회수 정책, 쓰고 난 메모리를 다시 확보하는 방식은 선택형으로 추가됐다. 개발자가 새 경로를 골라 적용할 수 있는 구성이다.
2. 어휘를 나눠 처리하는 학습 경로가 넓어졌다
AutoTP에는 어휘 병렬 언어 모델 출력층과 임베딩 지원이 추가됐다. 입력을 표현하는 임베딩부터 출력층까지 어휘를 나눠 처리하는 경로를 넓혔으며, 임베딩을 공유하는 모델 지원도 보강했다.
어휘를 나눠 처리하면서 학습 손실을 계산하는 융합 연산도 추가됐다. 출력층 지원과 손실 계산을 함께 확장했다는 점에서, 병렬 학습을 적용할 수 있는 처리 범위가 넓어진 변화다.
릴리스 본문은 개별 변경의 짧은 제목을 중심으로 구성돼 있으며, 성능 비교 수치나 측정 조건은 담고 있지 않다.
3. 학습 계산 누락과 저장 과정의 오류를 고쳤다
ZeRO-1·2에서는 CPU에서 비연속적으로 배치된 그레이디언트, 학습 과정에서 계산되는 기울기 값을 합산할 때 일부 묶음이 조용히 누락되는 문제를 수정했다. 학습에 쓰는 계산 결과 일부가 합산에서 빠지는 오류를 바로잡은 것이다.
ZeRO-2에서는 분할 저장 과정에서도 32비트 그레이디언트 누적 정밀도를 유지하도록 했다. 여러 장치로 나눈 학습 계산을 합치고 저장하는 과정의 정확성을 다룬 수정이다.
체크포인트, 학습 상태를 저장한 지점의 변환에서는 여러 조각이 같은 저장 조각의 주소에 쓰도록 지정된 맵을 거부한다. 같은 위치에 겹쳐 쓰는 배치 정보를 차단하도록 바뀐 것이다.
4. 삭제된 기능과 거부되는 설정을 먼저 확인한다
탄력적 학습, 참여 장치 수 변화에 대응하는 학습과 점진적 층 삭제, 학습 중 층을 단계적으로 빼는 방식의 지원은 제거됐다. 오래된 손실 함수 두 가지도 삭제됐으며, 압축 라이브러리 잔여 기능과 구형 커리큘럼 학습, 쉬운 과제부터 익히는 학습 방식은 폐기 예정으로 지정됐다. 업그레이드할 때는 의존 기능이 이미 삭제됐는지, 폐기 예정인지부터 확인하는 것이 실용적이다.
설정 문서에서는 sub_group_size를 설명하고 기본값을 1e9로 바로잡는 변경이 포함됐다. 이 항목은 기존 구성과 문서의 기본값을 대조할 때 살펴볼 지점이다.
DeepSpeedCPUAdam은 이전에 무시하던 amsgrad 설정을 이제 거부한다. 이 설정이 남아 있는 프로젝트는 새 버전을 적용하기 전에 최적화기 구성을 점검해야 한다.
병렬 처리 기능 확장과 계산 오류 수정이 이익이라면, 구형 기능을 사용하는 코드와 허용되지 않는 설정을 정리하는 작업은 개발자가 부담할 전환 비용이다. 특히 기능 삭제가 포함된 만큼, 패치 릴리스라는 이름보다 사용 중인 기능의 변경 내역이 적용 판단에 중요하다.
5. 가속기 지원과 빌드 조건도 바뀐다
NPU에는 고정된 호스트 메모리 등록, CPU 메모리를 장치 접근용으로 고정하는 처리와 그래프 연산, 연산들을 그래프로 묶어 실행하는 방식의 지원이 추가됐다. 장치에서 실행할 수 있는 연산과 메모리 처리 관련 지원을 보강한 변경이다.
NPU와 XPU의 연산 빌더, 연산 코드를 생성하고 빌드하는 도구에는 빌드 언어 표준 변경이 포함됐다.
torch 2.12 이상에서는 C++20을 사용하도록 바뀌었다. 해당 환경에서 연산을 빌드하는 개발자가 확인할 변경이다.
NPU에서는 폐기 예정인 Adam 호출을 융합 연산으로 대체했다. 릴리스에 적힌 교체 대상의 기존 호출은 다음과 같다.
npu_apply_adam(_w)이번 릴리스는 전문가 모델과 병렬 학습의 처리 범위를 넓히면서, 구형 기능의 정리와 가속기별 빌드 점검을 업그레이드 과제로 남긴다.