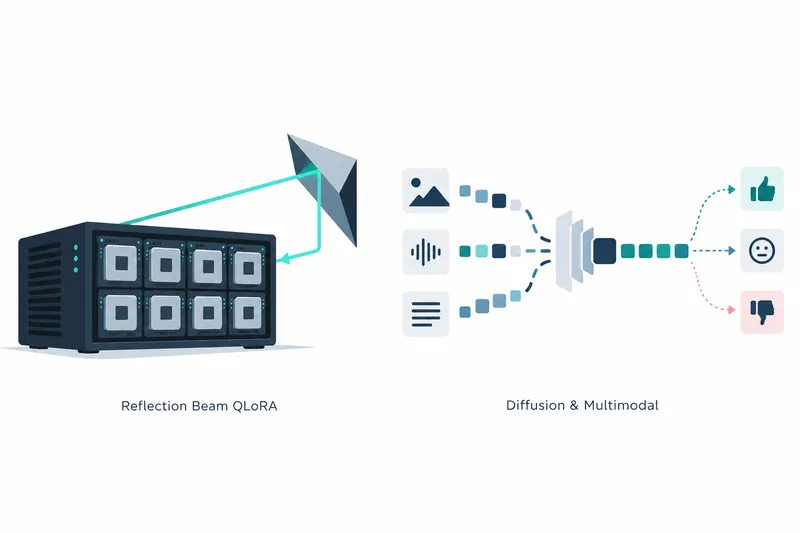
Axolotl이 대형 언어 모델을 조정하는 개발자를 위해 서버 한 대용 학습 설정을 제공했다. 확산 방식 언어 모델은 별도 플러그인 없이 학습하고, 이미지가 포함된 자료로도 응답 선호도와 보상을 학습할 수 있게 됐다.
1. 8장 서버에서 조정하는 초대형 모델
Reflection의 Beam은 전체 매개변수가 5010억 개이고 토큰마다 230억 개를 활성화하는 혼합 전문가 모델이다. 입력에 따라 일부 전문가만 계산에 참여하는 구조이며, 소프트웨어 개발과 장기간 여러 단계를 수행하는 에이전트 작업을 겨냥한다.
이번 배포는 H200 8개를 갖춘 단일 노드에서 QLoRA 미세조정을 지원한다. 이는 원래 가중치를 낮은 정밀도로 저장하고 작은 보정 가중치를 학습하는 방식이다. 모델 전체를 다시 학습하거나 저사양 장치에서 실행한다는 뜻은 아니다.
설정은 학습 상태를 분산하는 FSDP2 방식과 모델의 층을 장치에 나누는 device_map 방식으로 제공된다. 분산 방식과 보정 대상은 별개로 구분해야 한다.
어텐션은 입력의 어느 부분끼리 서로 참고하게 할지 정하는 계산이다. 두 분산 방식 모두 어텐션과 전문가 가중치를 보정하는 설정을 제공한다. device_map에는 어텐션만 보정하는 설정도 있다.
device_map 설정은 단일 프로세스로 실행한다. 보정 가중치가 여러 장치에 걸치면 가중치 갱신을 담당하는 adamw_torch_4bit 옵티마이저가 실패하므로, 문서가 지정한 adamw_torch를 써야 한다.
경로를 선택하는 라우터는 보정 학습 대상에서 제외해야 한다. 이를 학습하면 전문가 선택이 불안정해진다는 경고가 있다.
2. 확산 모델은 기본 학습 경로로 편입
확산 언어 모델은 가려지거나 잡음이 섞인 토큰을 복원하도록 학습한다. 새 최상위 설정인 diffusion_lm과 기존 대화 데이터셋을 쓰면 모델별 프로필이 잡음 과정, 어텐션 배치와 손실을 정한다.
확산 모델 안내에 따르면 지원 대상에는 Nemotron-Labs-Diffusion의 30억·80억 매개변수 모델과 Dream v0가 포함된다.
DiffusionGemma도 지원하지만, 이들 기본 학습은 작은 보정 가중치를 학습하는 LoRA 방식으로 제한된다.
Nemotron이 지원하는 가변 길이 어텐션은 길이가 다른 문서의 실제 토큰만 모아 계산하는 방식이다. 이 경로에는 Torch 2.14 이상이 필요하다. 문서의 설치 항목은 해당 경로를 위한 환경 설치 예시를 다음처럼 제시한다.
python -m venv .venv-diffusion
source .venv-diffusion/bin/activate
python -m pip install --upgrade pip
python -m pip install torch==2.14.0  # 또는 가속기에 맞는 휠
python -m pip install -e .
30억 매개변수 시작 예제는 합성 대화 32건으로 옵티마이저 갱신을 두 번 수행한다. 데이터 준비와 학습·저장을 확인하는 용도이며, 품질 평가가 아니다.
여러 문서를 한 행에 묶는 패킹은 주로 메모리를 절약한다. 문서는 처리량이 문서 길이와 어텐션 구현에 따라 달라지므로, 패킹을 켠 경우와 끈 경우를 직접 측정하도록 권한다.
3. 이미지 응답에도 선호와 보상 적용
릴리스 노트에 따르면 이미지 데이터셋에서 DPO와 KTO를 실행할 수 있게 됐다. 이미지를 포함한 입력에서도 응답을 선호에 맞게 조정하는 학습 경로가 생긴 것이다.
GRPO처럼 생성 응답의 보상을 활용하는 강화학습도 지원한다. 다만 이미지 학습의 품질 향상 수치는 제시되지 않았다.
이미지 강화학습용 생성 서버를 함께 쓰려면 vLLM 0.30.0 이상도 맞춰야 한다.
확산 모델의 이미지 입력은 별도 경로다. Nemotron-Labs-Diffusion-VLM-8B에서는 정해진 답변 칸에 라벨이나 점수 등을 채우도록 학습하는 전용 플러그인으로만 이미지를 받는다. 일반 지도 미세조정은 텍스트만 받고 멀티모달 데이터셋은 거부한다.
4. 이익은 통합, 비용은 실행 환경 점검
기본 확산 학습은 기존 플러그인 지정 대신 최상위 설정과 평소 쓰던 대화 데이터셋을 이용하므로 별도 플러그인 설정 부담을 줄인다. 기존 확산 설정은 경고와 함께 변환되므로, 전환 시 경고와 모델별 지원 범위를 확인하는 작업은 여전히 필요하다.
B200용 성능 안내는 별도 비교다. 장치끼리 데이터를 주고받을 때 DeepEP 대신 추가 설치가 필요 없는 기본 통신을 쓴 경로는 내부 소규모 시험에서 약 25% 느렸다.
입력 간 참조를 계산하는 구현도 차이가 난다. 같은 안내에서 FlashAttention 2는 이 모델 규모에서 FlashAttention 4보다 약 2배 느린 대안으로 설명된다. 두 수치는 해당 장치의 구현 선택에 관한 비교이지, 앞서 소개한 서버 구성의 속도나 비용 추정치가 아니다.
이번 버전의 가치는 대형 모델의 보정 학습과 확산·이미지 학습으로 대상을 넓히고, 기본 확산 학습의 별도 플러그인 설정 부담을 줄인 데 있다.