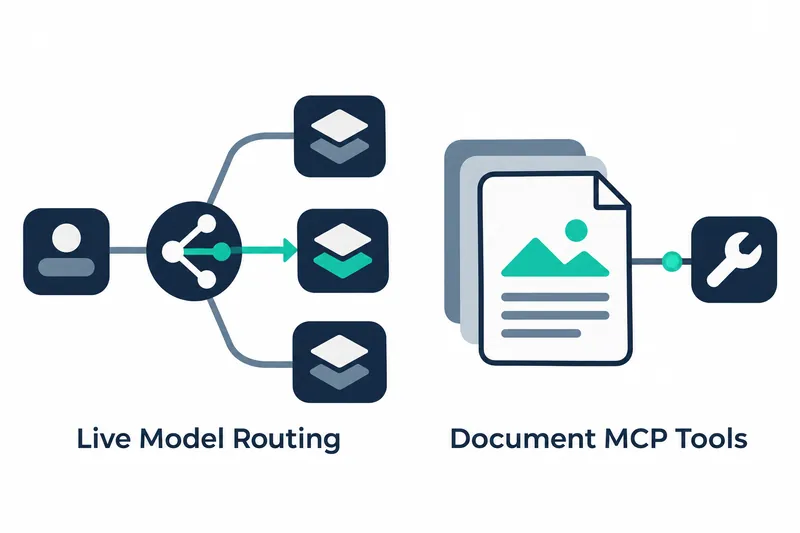
llama-swapは、リアルタイム音声接続を先に確立して後からモデルを選ぶ機能と、AIがプロジェクト文書をツールとして呼び出す機能を追加した。複数モデルにリクエストを振り分ける開発者にはモデル未指定による接続エラーを減らし、ヘルプエージェントを作る開発者には文書接続機能を再利用する道を開く変更だ。
1. 双方向データ通信方式のWebSocket接続後にモデルを選んでルーティング
今回の変更は、OpenAIが案内するリアルタイムAPI接続方式で接続し、モデル名を事前に指定しないクライアントに焦点を当てた。従来、このようなリクエストはWebSocketへの切り替え前に404エラーとなっていたが、v271ではllama-swapが先に接続手順を終え、モデルが決まってからリクエストを転送するようにした。
クライアントが音声の文字起こしを目的に接続すると、サーバーはsession.updateでモデルが指定されるまで、先に届いたイベントを一時保管する。ここではsession.modelを先に確認し、なければ音声を文字に変換する文字起こしモデルのキーから対象を探し、待機中のイベントを既存のルーティング経路に渡す。
まず受け付けを済ませ、担当モデルが決まったら蓄積したリクエストを渡す方式だ。処理に失敗すると、OpenAI形式のエラーイベントで通知する。
2. 文書と任意のソースコードをMCPツールとして提供
v271はllama-swapの文書をMCPツールとして公開するdocbotパッケージも追加した。MCPは、AIアプリケーションが外部機能をツールのように要求する接続方式だ。ヘルプエージェントを作る開発者は、文書提供機能を独立したパッケージとして取り込み、HTTPルートに接続でき、ソースコードを提供するかどうかも選べる。
パッケージには状態を保持しないMCPハンドラーが含まれ、SystemPrompt()とTools()のヘルパーでシステムプロンプトとツール一覧を提供する。開発者は、アプリケーションのHTTPルートに文書ツールを接続してこの機能を活用できる。
リリースノートは、このパッケージがllama-swap.aiのヘルプエージェントの先行作業であり、同サイトのヘルプMCPエンドポイントを含むと説明している。文書ベースのエージェントに必要な接続機能を、取り込んで使えるようにまとめた形だ。
3. 公開された学習資料と評価数値
ヘルプエージェント向けの小型モデルをファインチューニングし、追加学習でモデルの動作を調整した記録も含まれた。学習スクリプト、対話資料、実行メモが公開され、今後のヘルプモデルの学習過程を構築する際の参考資料として示された。
プロジェクトのリリースノートによると、LFM3-1.7Bベースのlfm3-v2 Q4_K_Mは、1問あたり60秒の制限付き評価で、学習事例のスコア95.5%、学習に使わず別に残したホールドアウト事例のスコア96.1%を記録した。学習に使った質問だけでなく、別に残した質問で得た結果も示したものだ。
別の文書エージェント評価には学習事例66件とホールドアウト事例29件を追加し、誤った検証項目4件を修正した。プロジェクトのリリースノートは、文書と評価をともに見直すことで、gemma-4-12B-r9700の学習スコアが96.0%から97.3%に上がったと述べた。
文書ツールget_docのデフォルト出力上限も250行から400行に増えた。リリースノートは、kubeswapのGPU予算設定例が途中で切れる問題を理由に挙げた。文書ページが回答を含むガイド文書を指すよう、リンクも整理した。
公開された学習資料には、モデルが学習した数値情報である重みは含まれていない。また、両モデルのスコアは評価条件が同じとは示されておらず、直接順位を付けることはできない。
4. 開発者とユーザーにとって変わる点
文書ツールの利点とコストは連動する。デフォルト出力が増えると、従来は途中で切れていた例をより完全に伝えられる一方、呼び出す側が一度に受け取って処理する文書量も増える。ヘルプシステムの構築時には、必要な範囲に合わせて結果を扱う作業が伴う。
ヘルプシステムを独自に構築する側は、文書をツールとして接続する機能と、モデル学習の参考資料を併用できる。文書提供部分はパッケージとして取り込み、独自のヘルプモデルを調整する場合は、公開された対話記録と実行メモを参考にする形だ。
v271の要点は、セッションが指定したモデルにリアルタイムリクエストを渡すことと、文書を再利用可能なAIツールとして提供することの2つの拡張だ。